논문명: Efficient Estimation of Word Representations in Vector Space
저자: Tomas Mikolov, Kai Chen, Greg Corrado, Jeffrey Dean
발표: ICLR 2013
link:https://arxiv.org/pdf/1301.3781
단어를 벡터로 표현하다
자연어 처리(NLP)를 공부하다 보면 가장 먼저 만나게 되는 개념 중 하나가 바로 Word Embedding(단어 임베딩)입니다.
오늘날 Transformer와 GPT 같은 언어 모델에서도 단어 또는 토큰을 벡터로 변환하는 과정은 매우 중요한 역할을 합니다.
이러한 단어 표현 방식의 발전에서 빼놓을 수 없는 대표적인 연구가 바로 Word2Vec입니다.
1. 연구 배경 (Background)
초기의 자연어 처리에서는 단어를 컴퓨터가 처리할 수 있도록 표현하기 위해 One-Hot Encoding과 같은 방법이 많이 사용되었습니다.
예를 들어 다음과 같은 단어가 있다고 가정해 보겠습니다.
King
Queen
Man
Woman
One-Hot Encoding에서는 각각의 단어를 다음처럼 표현할 수 있습니다.
King  → [1, 0, 0, 0]
Queen → [0, 1, 0, 0]
Man   → [0, 0, 1, 0]
Woman → [0, 0, 0, 1]
하지만 이러한 표현 방식에는 큰 문제가 있습니다.
각 단어가 서로 완전히 독립적인 벡터로 표현되기 때문에 단어 사이의 의미적 관계를 표현할 수 없습니다.
예를 들어 사람은 King과 Queen이 서로 관련된 단어라는 것을 쉽게 이해할 수 있지만, One-Hot Vector만 보면 두 단어 사이의 의미적 유사성을 알기 어렵습니다.
또한 단어의 수가 많아질수록 벡터의 차원도 매우 커지는 문제가 발생합니다.
이러한 문제를 해결하기 위해 연구자들은 단어를 고차원의 희소 벡터가 아니라 저차원의 Dense Vector로 표현하는 Distributed Representation을 연구하기 시작했습니다.
Word2Vec은 이러한 흐름 속에서 등장한 대표적인 Word Embedding 방법입니다.
2. 연구 목적 (Objective)
Word2Vec의 핵심 목표는 대규모 텍스트 데이터로부터 단어의 의미와 문법적 관계를 포함하는 효율적인 벡터 표현을 학습하는 것입니다.
즉,
Word
 ↓
Dense Vector
형태로 단어를 변환하는 것입니다.
예를 들어,
King → [0.21, -0.53, 0.81, ...]
처럼 하나의 단어를 수백 차원의 실수 벡터로 표현합니다.
중요한 점은 이 벡터가 단순히 단어를 구분하기 위한 번호가 아니라, 학습 과정에서 비슷한 문맥에서 등장하는 단어들이 비슷한 벡터를 가지도록 학습된다는 것입니다.
이를 통해 단어 사이의 의미적 관계를 벡터 공간에서 표현할 수 있습니다.
대표적으로 Word2Vec 연구에서 유명해진 예가 다음과 같은 관계입니다.
King - Man + Woman ≈ Queen
즉, 단어의 의미 관계가 벡터 공간에서 일정한 방향으로 나타날 수 있다는 것입니다.
3. 연구 방법 (Method)
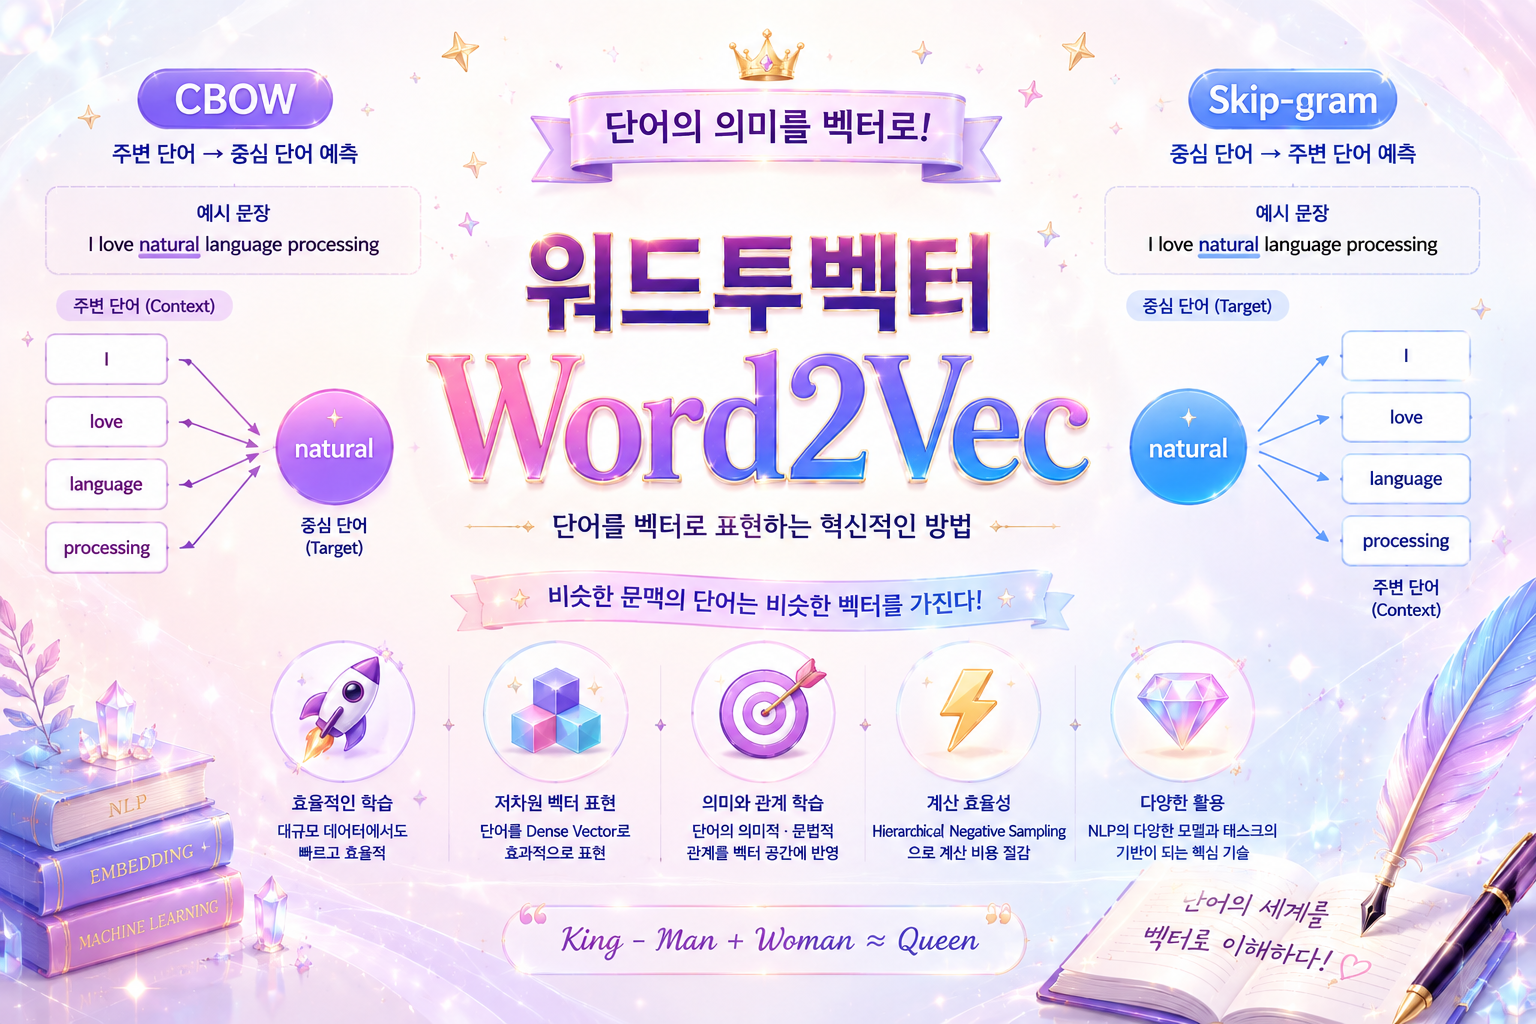
Word2Vec에서는 단어 벡터를 효율적으로 학습하기 위해 크게 두 가지 모델 구조를 제안합니다.
① CBOW (Continuous Bag-of-Words)
CBOW는 주변 단어(Context)를 이용하여 가운데 단어(Target Word)를 예측하는 방식입니다.
예를 들어 다음 문장이 있다고 가정해 보겠습니다.
I love natural language processing
natural을 예측한다고 하면,
I
love
?
language
processing
주변 단어들을 입력으로 사용하여 가운데 단어를 예측합니다.
구조를 단순화하면 다음과 같습니다.
Context Words
     ↓
Projection
     ↓
Target Word
즉,
주변 단어 → 중심 단어 예측
방식입니다.
CBOW는 여러 주변 단어의 정보를 함께 사용하기 때문에 학습 속도가 빠르고 빈도가 높은 단어를 학습하는 데 효과적입니다.
② Skip-gram
Skip-gram은 CBOW와 반대 방식입니다.
중심 단어를 이용하여 주변 단어를 예측합니다.
예를 들어,
I love natural language processing
에서 natural이 중심 단어라면,
natural
   ↓
love
language
와 같이 주변에 등장할 가능성이 높은 단어를 예측하도록 학습합니다.
구조는 다음과 같습니다.
Target Word
     ↓
Projection
     ↓
Context Words
즉,
중심 단어 → 주변 단어 예측
방식입니다.
Skip-gram은 학습량은 상대적으로 많지만, 희귀한 단어에서도 좋은 표현을 학습할 수 있다는 장점이 있습니다.
4. 학습 최적화 (Training Optimization)
Word2Vec의 중요한 특징 중 하나는 단순히 좋은 Word Embedding을 만드는 것뿐만 아니라 대규모 데이터에서도 빠르게 학습할 수 있도록 계산량을 줄였다는 점입니다.
기존 Neural Language Model에서는 전체 Vocabulary에 대해 Softmax를 계산해야 했습니다.
Vocabulary 크기가 수십만 또는 수백만 개가 되면 이 연산은 매우 비싸집니다.
이를 해결하기 위해 Word2Vec 연구에서는 여러 효율적인 학습 방법을 사용합니다.
Hierarchical Softmax
Vocabulary를 이진 트리 구조로 구성하여 전체 단어를 모두 계산하는 대신 트리를 따라가면서 단어를 예측합니다.
이를 통해 매우 큰 Vocabulary에서도 계산량을 줄일 수 있습니다.
Negative Sampling
후속 Word2Vec 연구에서는 Negative Sampling이라는 더욱 단순하고 효율적인 방법을 제안했습니다.
예를 들어 실제 문장에서
coffee → drink
이라는 관계가 등장했다면 이것을 Positive Sample로 사용합니다.
그리고 임의의 단어를 선택하여
coffee → mountain
coffee → airplane
coffee → computer
와 같은 Negative Sample을 생성합니다.
모델은
실제로 같이 등장하는 단어 → 높은 점수
관계없는 단어 → 낮은 점수
를 갖도록 학습합니다.
이를 통해 전체 Vocabulary를 매번 계산하지 않고 일부 Negative Sample만 계산하면서 효율적으로 Word Embedding을 학습할 수 있습니다.
5. 실험 (Experiment)
Word2Vec 연구에서는 대규모 텍스트 데이터를 이용하여 단어 벡터를 학습하고 기존 Neural Network 기반 언어 모델들과 비교했습니다.
특히 최대 약 16억(1.6 billion) 단어 규모의 데이터셋을 이용한 실험을 수행했습니다.
Word Vector의 품질을 평가하기 위해 단순히 단어의 유사도만 측정한 것이 아니라 Semantic Relationship과 Syntactic Relationship을 평가하는 테스트를 사용했습니다.
대표적인 Semantic 관계는 다음과 같습니다.
King : Queen
Man  : Woman
또는
Paris  : France
Berlin : Germany
와 같은 관계입니다.
Syntactic 관계에서는 다음과 같은 문법적 변화를 평가합니다.
quick : quickly
slow  : slowly
또는
big : bigger
small : smaller
이러한 관계가 Word Vector 공간에서도 일정한 방향으로 표현되는지를 확인했습니다.
6. 실험 결과 (Result)
Word2Vec은 기존 Neural Network 기반 Word Representation 방법보다 훨씬 낮은 계산 비용으로 높은 품질의 단어 벡터를 학습할 수 있음을 보여주었습니다.
특히 연구에서는 대규모 데이터셋에서도 매우 효율적인 학습이 가능하다는 것을 확인했습니다.
약 16억 개의 단어로 구성된 데이터에서도 하루 이내에 고품질 Word Vector를 학습할 수 있음을 보고했습니다.
또한 학습된 Word Vector에서는 단순한 단어 유사도를 넘어 다양한 의미적·문법적 관계가 나타났습니다.
대표적으로 다음과 같은 Vector Arithmetic이 가능했습니다.
King - Man + Woman ≈ Queen
이를 수식처럼 표현하면,
vector("King")
- vector("Man")
+ vector("Woman")
≈ vector("Queen")
이 결과는 단어의 의미 관계가 단순한 기호가 아니라 Vector Space의 방향과 거리로 표현될 수 있다는 점을 보여주었습니다.
7. 장점과 한계 (Pros & Cons)
장점
- 단어의 의미를 Dense Vector 형태로 효과적으로 표현
- 기존 Neural Language Model보다 계산량이 적고 학습 속도가 빠름
- 대규모 텍스트 데이터 학습 가능
- CBOW와 Skip-gram이라는 단순하고 효율적인 구조 제안
- 단어 사이의 Semantic / Syntactic 관계를 Vector Space에서 표현 가능
- 이후 NLP에서 Word Embedding을 활용하는 방식의 대중화에 큰 영향을 미침
한계
- 하나의 단어에 하나의 고정된 벡터를 사용
예를 들어,
bank
라는 단어는
river bank
bank account
에서 서로 다른 의미를 가지지만 Word2Vec에서는 기본적으로 동일한 벡터로 표현됩니다.
- 문장의 전체 문맥을 직접적으로 이해하기 어려움
- 단어 순서 정보를 충분히 반영하지 못함
- 학습 데이터에 없는 단어(OOV, Out-of-Vocabulary)를 처리하기 어려움
- 형태소나 Subword 정보를 기본 Word2Vec 모델에서는 직접 활용하지 않음
- 학습 데이터에 존재하는 사회적 편향이 Word Vector에도 반영될 수 있음
이러한 문제들은 이후 FastText, ELMo, BERT와 같은 모델에서 점차 개선되었습니다.
8. 개인적인 평가 (Comment)
Word2Vec은 자연어 처리에서 “단어를 컴퓨터가 어떻게 이해할 수 있는 형태로 표현할 것인가?”라는 문제에 매우 단순하면서도 강력한 해결책을 제시한 대표적인 연구입니다.
특히 단어를 단순한 ID나 One-Hot Vector로 처리하는 것을 넘어, 단어의 의미와 관계를 연속적인 Vector Space 안에서 학습할 수 있다는 가능성을 명확하게 보여주었다는 점에서 의미가 큽니다.
One-Hot Encoding
       ↓
Word2Vec
       ↓
Word Embedding
       ↓
ELMo / BERT
       ↓
Transformer / GPT
물론 오늘날의 Transformer 기반 언어 모델에서는 Word2Vec처럼 단어마다 하나의 고정된 벡터를 사용하는 방식에서 발전하여 문맥에 따라 표현이 달라지는 Contextual Embedding을 사용합니다.
하지만 Word2Vec이 보여준
“언어의 의미를 벡터 공간에서 표현할 수 있다.”
라는 아이디어는 현대 자연어 처리와 언어 모델을 이해하는 데 매우 중요한 출발점이라고 생각합니다.
특히 Word2Vec을 공부하면 이후 등장하는 Embedding Layer, Attention, Transformer, BERT, GPT의 Token Embedding이 왜 필요한지를 훨씬 자연스럽게 이해할 수 있습니다.
자연어 처리와 Transformer를 공부하는 사람이라면 반드시 한 번 공부해볼 가치가 있는 고전적인 연구이며, 현대 NLP의 발전 과정을 이해하기 위한 가장 좋은 출발점 중 하나라고 생각합니다.
핵심 한 줄 정리
Word2Vec은 단어를 단순한 기호가 아니라, 의미와 관계를 가진 벡터로 학습함으로써 현대 Word Embedding과 NLP 발전의 중요한 기반을 마련한 연구입니다.