논문명: GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
저자: Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, Sumit Sanghai (Google)
발표: arXiv , EMNLP 2023
link:https://arxiv.org/pdf/2305.13245
1. 연구 배경 (Background)
Transformer 모델에서는 일반적으로 Multi-Head Attention(MHA)을 사용하여 여러 Attention Head가 서로 다른 정보를 학습하도록 설계합니다.
그러나 GPT와 같은 자기회귀(Autoregressive) 언어 모델은 토큰을 하나씩 생성하기 때문에, 추론 과정에서 이전 토큰들의 Key와 Value를 반복적으로 참조해야 합니다.
이를 효율적으로 처리하기 위해 KV Cache(Key-Value Cache) 를 사용하지만, 모델 크기와 입력 시퀀스 길이가 증가할수록 메모리 사용량과 메모리 대역폭 부담도 커집니다.
이러한 문제를 해결하기 위해 Multi-Query Attention(MQA)이 제안되었습니다.
MQA는 여러 Query Head가 하나의 Key-Value Head를 공유하여 KV Cache 사용량을 크게 줄이지만, 일부 작업에서는 기존 MHA보다 모델 성능이 저하될 수 있다는 한계가 있었습니다.
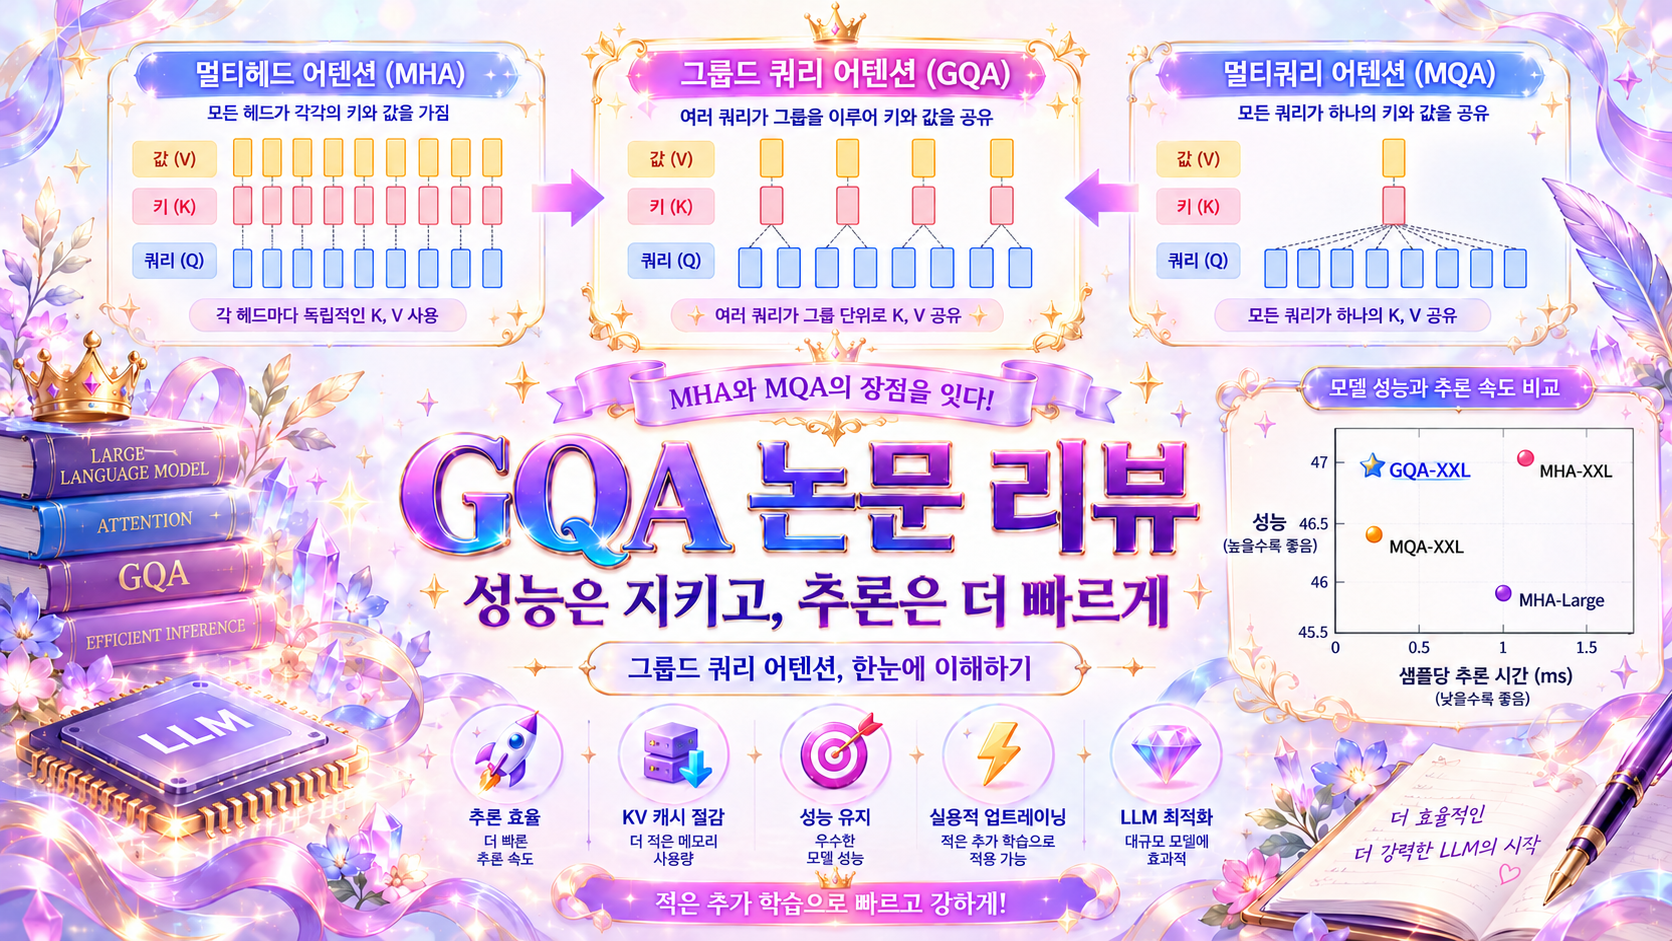
GQA(Grouped-Query Attention)는 이러한 문제를 해결하기 위해 MHA의 높은 성능과 MQA의 빠른 추론 속도 사이에서 균형을 찾는 방법으로 제안되었습니다.
2. 연구 목적 (Objective)
GQA의 주요 목표는 기존 Multi-Head Attention의 성능을 최대한 유지하면서, 언어 모델의 추론 속도를 향상시키고 KV Cache의 메모리 사용량을 줄이는 것입니다.
또한 이미 학습된 MHA 기반 언어 모델을 처음부터 다시 학습하지 않고, 적은 추가 학습 비용으로 MQA 또는 GQA 구조로 변환하는 방법을 제안하고자 하였습니다.
구체적인 연구 목표는 다음과 같습니다.
- MHA의 높은 모델 성능 유지
- MQA에 가까운 빠른 추론 속도 달성
- KV Cache 크기와 메모리 대역폭 사용량 감소
- 기존 MHA 체크포인트를 활용한 효율적인 추가 학습(Uptraining)
- 모델 크기에 따라 Key-Value Head 수를 유연하게 조절할 수 있는 Attention 구조 제안
3. 연구 방법 (Method)
GQA는 여러 Query Head를 그룹으로 나누고, 각 그룹이 하나의 Key Head와 Value Head를 공유하도록 설계된 Attention 구조입니다.
3.1 MHA, GQA, MQA 구조 비교
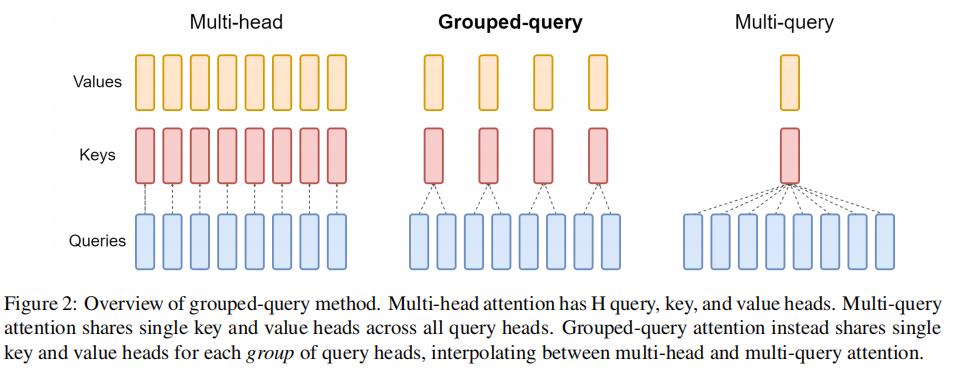
Figure 2. Multi-Head Attention, Grouped-Query Attention, Multi-Query Attention의 구조 비교 (Ainslie et al., 2023)
위 그림은 세 가지 Attention 구조에서 Query, Key, Value Head가 어떻게 연결되는지 보여줍니다.
① Multi-Head Attention (MHA)
MHA에서는 각각의 Query Head가 독립적인 Key와 Value Head를 사용합니다.
그림에서는 8개의 Query Head에 대응하여 8개의 Key Head와 8개의 Value Head가 존재합니다.
이러한 구조는 각 Attention Head가 서로 다른 정보를 학습할 수 있도록 하지만, 모든 Key와 Value를 저장해야 하므로 KV Cache의 메모리 사용량이 커집니다.
② Multi-Query Attention (MQA)
MQA에서는 모든 Query Head가 하나의 Key Head와 Value Head를 공유합니다.
그림에서 8개의 Query Head는 유지되지만, Key와 Value Head는 각각 하나만 존재합니다.
이를 통해 KV Cache 크기와 메모리 대역폭 사용량을 크게 줄일 수 있지만, Key와 Value의 표현 능력이 제한되어 모델 성능이 저하될 가능성이 있습니다.
③ Grouped-Query Attention (GQA)
GQA는 MHA와 MQA의 중간 형태로, 여러 Query Head를 그룹으로 묶어 Key와 Value를 공유합니다.
그림에서는 8개의 Query Head를 4개의 그룹으로 나누고, 각 그룹의 Query Head 2개가 하나의 Key와 Value를 공유합니다.
따라서 MHA보다 적은 KV Head를 사용하면서도 MQA보다 다양한 Key-Value 표현을 유지할 수 있습니다.
| 구조 | Query Head | KV Head | 특징 |
|---|---|---|---|
| MHA | 8 | 8 | 독립적인 K, V |
| GQA | 8 | 4 | 그룹별 K, V 공유 |
| MQA | 8 | 1 | 전체 Query가 K, V 공유 |
GQA의 그룹 수를 G, Query Head 수를 H라고 하면 다음과 같이 정의할 수 있습니다.
- GQA-1 = MQA: 모든 Query Head가 하나의 KV Head 공유
- GQA-H = MHA: 모든 Query Head가 독립적인 KV Head 사용
- 1 < G < H: 여러 Query Head가 그룹별로 KV Head 공유
동일한 Head 차원과 시퀀스 길이를 가정하면 KV Cache의 크기는 KV Head 수에 비례하므로 다음과 같이 표현할 수 있습니다.
예를 들어 Query Head가 32개이고 KV Head가 8개라면, GQA의 KV Cache 크기는 기존 MHA의 약 25%로 감소합니다.
즉, GQA는 Query Head의 개수는 유지하면서 Key와 Value의 중복 저장을 줄이는 방식으로 추론 효율성을 개선합니다.
3.2 Uptraining
논문에서는 기존에 학습된 MHA 모델을 GQA 구조로 효율적으로 변환하는 Uptraining 방법도 제안하였습니다.
주요 과정은 다음과 같습니다.
- 기존 MHA 모델의 체크포인트를 불러옵니다.
- 같은 그룹에 속하는 Key와 Value Projection Matrix를 각각 평균화(Mean Pooling)합니다.
- Query Head는 유지하면서 그룹별 Key와 Value Head를 구성합니다.
- 변환된 모델에 추가 사전학습을 수행하여 새로운 Attention 구조에 적응시킵니다.
논문에서는 기존 사전학습 단계의 약 5%에 해당하는 추가 학습을 통해 GQA가 MHA에 가까운 성능을 확보할 수 있음을 보여주었습니다.
이 방법은 새로운 모델을 처음부터 학습하지 않고 기존 체크포인트를 재사용할 수 있다는 점에서 중요한 의미가 있습니다.
4. 실험 (Experiment)
실험은 T5.1.1 모델을 기반으로 수행되었으며, MHA, MQA, GQA 구조의 모델 성능과 추론 시간을 비교하였습니다.
주요 실험 환경은 다음과 같습니다.
- 기본 모델: T5-Large, T5-XXL
- 비교 구조: MHA, MQA, GQA-8
- 추가 학습: 기존 사전학습 단계의 5%
- 추론 측정 환경: TPUv4
- 평가 지표: 추론 시간, ROUGE-1, BLEU, F1 Score
모델 성능은 문서 요약, 기계 번역, 질의응답 작업을 통해 평가하였습니다.
- 문서 요약: CNN/Daily Mail, arXiv, PubMed, MediaSum, MultiNews
- 기계 번역: WMT 2014 English-to-German
- 질의응답: TriviaQA
특히 Figure 3에서는 서로 다른 모델 크기와 Attention 구조를 비교하여 추론 속도와 모델 성능 사이의 Trade-off를 분석하였습니다.
5. 실험 결과 (Result)
5.1 Figure 3: 추론 속도와 모델 성능의 관계
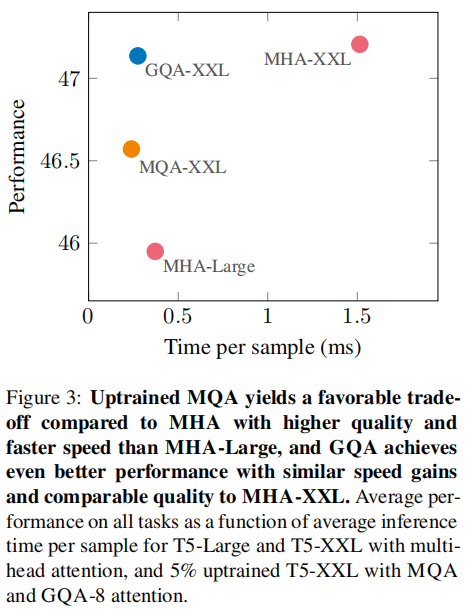
Figure 3. T5 모델의 추론 시간과 평균 성능 비교 (Ainslie et al., 2023)
Figure 3은 GQA 논문에서 가장 중요한 실험 결과 중 하나입니다.
- X축(Time per sample): 샘플당 평균 추론 시간으로, 값이 작을수록 빠른 모델을 의미합니다.
- Y축(Performance): 여러 평가 작업의 평균 성능으로, 값이 클수록 높은 성능을 의미합니다.
따라서 그래프에서 왼쪽 위에 위치할수록 빠른 추론 속도와 높은 모델 성능을 동시에 달성한 것으로 해석할 수 있습니다.
논문의 Table 1에서 제시한 결과는 다음과 같습니다.
| 모델 | 추론 시간 (s) | 평균 성능 |
|---|---|---|
| MHA-Large | 0.37 | 46.0 |
| MHA-XXL | 1.51 | 47.2 |
| MQA-XXL | 0.24 | 46.6 |
| GQA-8-XXL | 0.28 | 47.1 |
Table 1. 모델별 추론 시간 및 평균 성능. Figure 3의 가로축에는 ms로 표시되어 있으나 Table 1은 s 단위를 사용하므로, 여기서는 Table 1을 기준으로 작성하였습니다. 평균 성능은 여러 작업의 평가 점수를 단순 평균한 값입니다.
5.2 MHA-Large와 MHA-XXL: 모델이 커질수록 성능은 향상되지만 속도는 감소
MHA-Large는 평균 성능 46.0, 추론 시간 0.37초를 기록하였습니다.
반면 모델 크기가 더 큰 MHA-XXL은 평균 성능이 47.2로 향상되었지만, 추론 시간은 1.51초로 크게 증가하였습니다.
즉, 모델의 크기를 증가시키면 성능은 향상될 수 있지만 더 많은 연산량과 메모리 접근이 필요하기 때문에 추론 비용도 증가합니다.
실제로 MHA-XXL은 MHA-Large보다 약 4.1배 긴 추론 시간이 필요했습니다.
이는 대규모 언어 모델에서 단순히 모델 크기를 증가시키는 것만으로는 효율적인 추론을 달성하기 어렵다는 것을 보여줍니다.
5.3 MQA-XXL: 작은 모델보다 빠르면서 더 높은 성능 달성
MQA-XXL은 평균 성능 46.6, 추론 시간 0.24초를 기록하였습니다.
MHA-Large와 비교하면 다음과 같습니다.
- 모델 성능: 46.0 → 46.6으로 향상
- 추론 시간: 0.37초 → 0.24초로 감소
- 추론 속도: 약 1.54배 향상
주목할 점은 MQA-XXL이 더 큰 모델임에도 불구하고 MHA-Large보다 빠르고 높은 성능을 기록했다는 것입니다.
이는 Attention 구조를 효율적으로 설계하면 모델 크기를 유지하거나 증가시키면서도 추론 시간을 줄일 수 있음을 보여줍니다.
하지만 MQA-XXL은 MHA-XXL과 비교하면 평균 성능이 47.2에서 46.6으로 감소하였습니다.
즉, MQA는 빠른 추론 속도를 확보하는 대신 일부 모델 성능을 희생하는 Trade-off가 존재합니다.
5.4 GQA-XXL: MHA에 가까운 성능과 MQA에 가까운 속도 달성
GQA-8-XXL은 평균 성능 47.1, 추론 시간 0.28초를 기록하였습니다.
이는 Figure 3에서 가장 주목할 만한 결과입니다.
① MHA-XXL과의 비교
- MHA-XXL 성능: 47.2
- GQA-XXL 성능: 47.1
- 성능 차이: 단 0.1점
반면 추론 시간은 다음과 같습니다.
- MHA-XXL: 1.51초
- GQA-XXL: 0.28초
GQA-XXL은 MHA-XXL과 거의 동일한 평균 성능을 유지하면서 추론 시간을 약 81.5% 줄였으며, 약 5.4배 빠른 추론 속도를 달성하였습니다.
② MQA-XXL과의 비교
- MQA-XXL 성능: 46.6
- GQA-XXL 성능: 47.1
- 성능 차이: 0.5점 향상
추론 시간은 MQA-XXL의 0.24초에서 GQA-XXL의 0.28초로 소폭 증가하였습니다.
즉, GQA는 MQA보다 약간 느리지만 모델 성능을 MHA 수준에 가깝게 회복하였습니다.
이 결과는 GQA가 MHA와 MQA의 장점을 효과적으로 결합했음을 보여줍니다.
5.5 Figure 3에서 확인할 수 있는 핵심 의미
Figure 3에서 MHA-XXL은 오른쪽 위에 위치합니다. 높은 성능을 제공하지만 추론 시간이 길다는 의미입니다.
반면 MQA-XXL은 왼쪽에 위치하여 빠른 추론 속도를 보여주지만, 성능은 MHA-XXL보다 낮습니다.
GQA-XXL은 MQA-XXL에 가까운 가로축 위치를 유지하면서 MHA-XXL에 가까운 세로축 위치를 확보하였습니다.
이는 GQA가 추론 효율성과 모델 성능 사이에서 매우 유리한 Trade-off를 달성했다는 것을 의미합니다.
또한 MHA-Large는 GQA-XXL보다 추론 시간이 길면서도 모델 성능이 낮습니다. 따라서 이 실험에서는 GQA-XXL이 MHA-Large보다 속도와 성능 양쪽에서 우수한 결과를 보였습니다.
다만 Figure 3의 평균 성능은 서로 다른 작업의 ROUGE-1, BLEU, F1 점수를 평균한 값이므로 절대적인 모델 성능 지표로 해석하기보다는, 동일한 실험 조건에서 여러 모델을 비교하는 지표로 이해하는 것이 적절합니다.
또한 제시된 속도 향상은 특정 TPU 환경과 배치 구성에서 측정된 결과이므로 모든 하드웨어에서 동일하게 재현된다고 볼 수는 없습니다.
그럼에도 이 실험은 GQA의 핵심 아이디어를 명확하게 보여줍니다.
모든 Query Head가 독립적인 Key와 Value를 가질 필요는 없으며, 적절한 수의 KV Head를 공유하더라도 모델 성능을 거의 유지하면서 추론 효율성을 크게 높일 수 있다는 것입니다.
6. 장점과 한계 (Pros & Cons)
장점
- MHA와 유사한 성능을 유지하면서 추론 속도 향상
- KV Cache 크기 감소를 통한 메모리 효율 개선
- MQA 대비 모델 표현 능력과 성능을 더 효과적으로 유지
- 기존 MHA 체크포인트를 활용한 Uptraining 가능
- KV Head 수를 조절하여 모델 성능과 추론 효율 사이의 균형 설정
- 대규모 언어 모델의 추론 최적화에 실용적인 Attention 구조 제시
한계
- MHA에서 GQA로 변환하기 위한 추가 학습 비용 발생
- MQA보다 많은 KV Head를 사용하므로 메모리 절감 효과는 상대적으로 작음
- KV Head 수와 그룹 구성에 따라 모델 성능과 추론 속도가 달라질 수 있음
- Key와 Value를 평균화하는 과정에서 기존 Head의 일부 정보가 손실될 가능성
- T5 모델과 특정 TPU 환경을 중심으로 실험이 진행되어 다른 모델 및 하드웨어 환경에서의 추가 검증 필요
- KV Cache 사용량 감소가 모든 상황에서 동일한 비율의 추론 시간 감소로 이어지지는 않음
7. 개인적인 평가 (Comment)
GQA는 기존 Transformer의 Attention 구조를 완전히 새롭게 설계하기보다는, Multi-Head Attention과 Multi-Query Attention의 장점을 결합하여 대규모 언어 모델의 추론 효율성을 높인 실용적인 연구라고 생각합니다.
특히 Query Head의 개수는 유지하면서 Key-Value Head를 그룹 단위로 공유하도록 설계한 점이 인상적입니다. 이를 통해 모델의 표현 능력을 최대한 보존하면서 KV Cache와 메모리 대역폭 부담을 줄일 수 있다는 것을 보여주었습니다.
또한 기존에 학습된 MHA 체크포인트를 활용하는 Uptraining 방법은 처음부터 새로운 모델을 학습해야 하는 비용을 줄일 수 있다는 점에서 실용적인 의미가 큽니다.
GQA는 이후 Llama 2의 일부 모델과 Llama 3 등 다양한 대규모 언어 모델에서도 채택되었으며, 효율적인 LLM 추론을 위한 중요한 Attention 구조 중 하나로 자리 잡았습니다.
Transformer의 Attention 구조와 LLM의 추론 최적화 과정을 공부하는 사람이라면 반드시 한 번 읽어볼 가치가 있는 논문이며, MHA에서 MQA와 GQA로 이어지는 Attention 구조의 발전 과정을 이해하기에 매우 적합한 연구라고 생각합니다.