ChatGPT는 어떻게 사람의 언어를 이해하고 생성할까?
최근 ChatGPT를 비롯한 생성형 인공지능(AI)이 다양한 분야에서 활용되면서 대규모 언어 모델(LLM, Large Language Model) 에 대한 관심도 높아지고 있습니다.
ChatGPT를 사용해 본 사람이라면 한 번쯤 이런 궁금증을 가져봤을 것입니다.
- ChatGPT는 어떻게 자연스러운 문장을 생성할까?
- GPT의 핵심 기술인 트랜스포머(Transformer)는 어떤 구조일까?
- 어텐션(Attention)은 어떤 원리로 작동할까?
- 나만의 언어 모델을 직접 만들 수도 있을까?
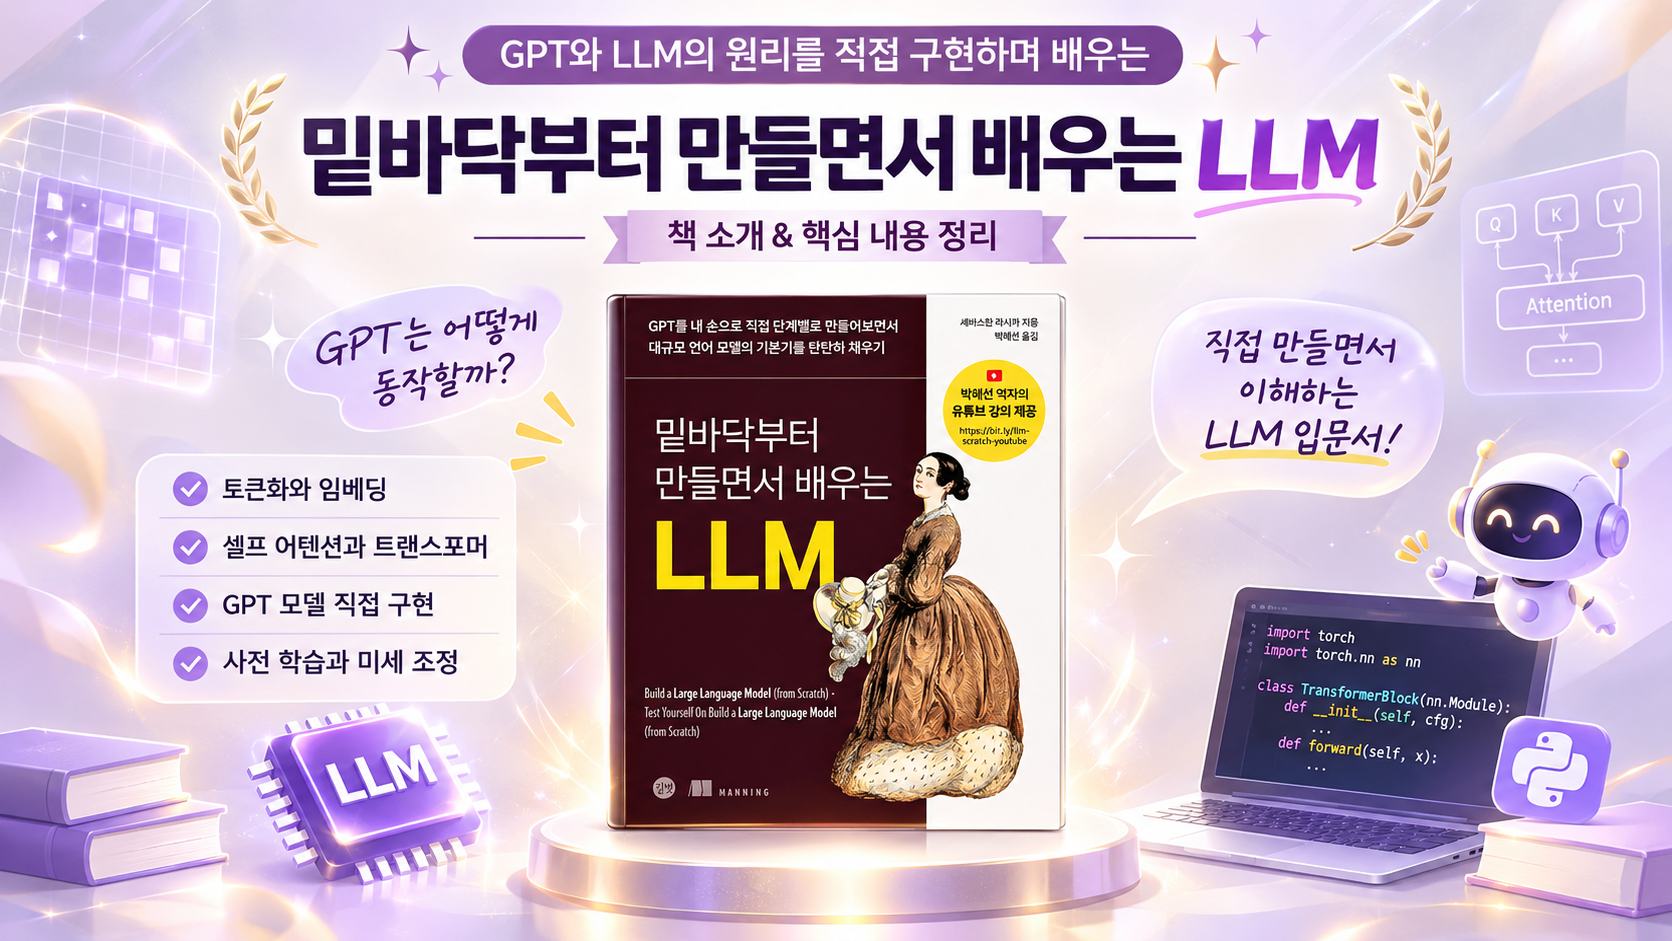
이러한 질문에 대한 답을 직접 코드를 작성하며 찾아보고 싶다면 《밑바닥부터 만들면서 배우는 LLM》 을 추천합니다.
이 책은 단순히 ChatGPT를 활용하는 방법을 소개하는 것이 아니라, GPT 모델을 처음부터 직접 구현하면서 대규모 언어 모델의 구조와 작동 원리를 이해할 수 있도록 구성된 실습 중심의 도서입니다.
책 소개
- 도서명: 밑바닥부터 만들면서 배우는 LLM
- 원제: Build a Large Language Model (From Scratch)
- 저자: 세바스찬 라시카(Sebastian Raschka)
- 역자: 박해선
- 출판사: 길벗
- 출간일: 2025년 9월 22일
- 분야: 인공지능(AI), 딥러닝, 자연어 처리(NLP), LLM
- 사용 언어 및 프레임워크: Python, PyTorch
이 책의 가장 큰 특징은 이미 만들어진 언어 모델을 사용하는 것이 아니라, 모델을 구성하는 핵심 요소를 하나씩 직접 구현한다는 점입니다.
텍스트를 숫자로 변환하는 토큰화(Tokenization)부터 임베딩(Embedding), 셀프 어텐션(Self-Attention), 트랜스포머 블록(Transformer Block)까지 단계별로 학습합니다.
이후 각각의 구성 요소를 결합하여 GPT와 유사한 언어 모델을 완성하고, 사전 학습(Pretraining)과 미세 조정(Fine-tuning)까지 경험할 수 있습니다.
이 책에서 배울 수 있는 핵심 내용
1. 텍스트 전처리와 토큰화(Tokenization)
언어 모델은 사람이 사용하는 문장을 그대로 이해하는 것이 아니라, 텍스트를 숫자로 변환하여 처리합니다.
이 과정에서 중요한 역할을 하는 것이 바로 토큰화와 임베딩입니다.
책에서는 텍스트 데이터를 모델이 처리할 수 있는 형태로 변환하는 과정을 살펴보고, 토큰을 벡터로 표현하는 방법을 학습합니다.
이를 통해 언어 모델이 문장을 입력받아 처리하는 기본적인 흐름을 이해할 수 있습니다.
2. 셀프 어텐션(Self-Attention)과 트랜스포머(Transformer)
트랜스포머는 현대 대규모 언어 모델의 핵심 아키텍처입니다.
특히 셀프 어텐션은 문장에 포함된 단어들이 서로 어떤 관계를 갖는지 파악하는 데 중요한 역할을 합니다.
이 책에서는 다음과 같은 개념을 직접 구현하며 학습합니다.
- 셀프 어텐션(Self-Attention)
- 쿼리(Query), 키(Key), 값(Value)
- 멀티헤드 어텐션(Multi-Head Attention)
- 위치 임베딩(Positional Embedding)
- 트랜스포머 블록(Transformer Block)
단순히 개념을 암기하는 것이 아니라, 실제 코드에서 데이터가 어떻게 계산되고 전달되는지 확인할 수 있다는 점이 특징입니다.
3. GPT 모델 직접 구현하기
앞서 학습한 구성 요소들을 결합하여 GPT와 유사한 언어 모델을 구현합니다.
이 과정에서 임베딩 계층, 어텐션 계층, 피드포워드 신경망, 정규화 계층 등이 하나의 모델 안에서 어떻게 연결되는지 살펴볼 수 있습니다.
또한 모델의 파라미터 수와 전체 구조를 확인하면서, 언어 모델이 텍스트를 입력받아 다음 토큰을 예측하는 과정을 이해하게 됩니다.
LLM을 하나의 복잡한 인공지능 시스템으로 바라보는 것이 아니라, 여러 신경망 구성 요소가 결합된 구조로 이해할 수 있도록 도와줍니다.
4. 언어 모델의 사전 학습(Pretraining)
모델의 구조를 완성한 후에는 실제 텍스트 데이터를 활용하여 학습을 진행합니다.
언어 모델은 대량의 텍스트에서 다음 토큰을 예측하는 과제를 수행하면서 언어의 통계적 패턴과 문맥적 관계를 학습합니다.
책에서는 손실 함수(Loss Function), 옵티마이저(Optimizer), 학습 루프(Training Loop) 등을 활용하여 모델의 파라미터가 업데이트되는 과정을 살펴봅니다.
이를 통해 딥러닝 모델이 단순히 데이터를 입력받는 것을 넘어, 학습을 통해 예측 성능을 개선하는 원리를 이해할 수 있습니다.
5. 미세 조정(Fine-tuning)과 모델 활용
사전 학습된 언어 모델은 특정 목적에 맞게 추가 학습을 진행할 수 있습니다. 이를 미세 조정이라고 합니다.
책에서는 텍스트 분류와 지시 기반 학습(Instruction Fine-tuning)을 다루며, 사전 학습된 모델을 다양한 작업에 활용하는 방법을 소개합니다.
또한 LoRA(Low-Rank Adaptation)와 같은 파라미터 효율적 미세 조정 기법도 학습할 수 있습니다.
이 책의 특징
① 이론과 실습을 함께 학습할 수 있다
책에서 설명하는 개념을 Python과 PyTorch 코드로 직접 구현할 수 있습니다. 추상적으로 느껴지는 신경망 구조를 실제 코드와 연결해 이해하는 데 도움이 됩니다.
② GPT의 내부 구조를 단계별로 이해할 수 있다
토큰화부터 트랜스포머, 모델 학습, 미세 조정까지 연결된 흐름으로 구성되어 있어 LLM의 전체적인 작동 과정을 파악할 수 있습니다.
③ 복잡한 개념을 그림과 코드로 설명한다
어텐션과 트랜스포머처럼 처음 접하면 어렵게 느껴질 수 있는 개념을 시각적인 설명과 구현 예제를 통해 이해할 수 있도록 돕습니다.
④ 단순한 AI 활용을 넘어 모델 개발의 기초를 배울 수 있다
기존 AI 서비스를 사용하는 방법뿐 아니라, 언어 모델을 직접 설계하고 학습하는 데 필요한 기본 지식을 쌓을 수 있습니다.
이런 분들에게 추천합니다
- ChatGPT와 LLM의 내부 작동 원리가 궁금한 분
- 트랜스포머와 어텐션 구조를 체계적으로 공부하고 싶은 분
- Python과 PyTorch를 활용한 딥러닝 실습에 관심 있는 분
- GPT 모델을 처음부터 직접 구현해 보고 싶은 분
- 생성형 AI와 자연어 처리 분야를 더 깊이 공부하고 싶은 분
다만 이 책은 Python 프로그래밍과 딥러닝의 기본 개념을 어느 정도 알고 있는 학습자에게 더욱 적합합니다.
신경망, 행렬 연산, 역전파 등의 개념이 처음이라면 딥러닝 기초를 먼저 학습한 후 읽는 것을 추천합니다.
마무리
생성형 AI를 공부할 때 중요한 것은 단순히 모델을 사용하는 방법을 익히는 것뿐만 아니라, 모델이 어떤 구조로 이루어져 있고 어떻게 학습하는지 이해하는 것입니다.
《밑바닥부터 만들면서 배우는 LLM》은 이러한 원리를 직접 코드로 구현하면서 학습할 수 있도록 도와주는 책입니다.
특히 셀프 어텐션, 트랜스포머, GPT 아키텍처 등 대규모 언어 모델의 핵심 개념을 체계적으로 공부하고 싶은 분들에게 유용한 학습 자료가 될 것입니다.
LLM을 단순히 사용하는 단계를 넘어, 직접 만들면서 이해하고 싶다면 읽어볼 만한 책입니다.
기타 참조 링크:
1. 자자 공식 GitHub – 예제 코드 및 실습 자료
https://github.com/rasbt/LLMs-from-scratch
책에서 사용하는 Python 및 PyTorch 예제 코드와 Jupyter Notebook을 확인할 수 있습니다.
2. 저자 공식 학습 자료 페이지
https://sebastianraschka.com/llms-from-scratch
각 장의 예제 코드와 추가 설명, 관련 학습 자료를 확인할 수 있습니다.