논문명: GLU Variants Improve Transformer
저자: Noam Shazeer (Google)
발표: arXiv, 2020
link:https://arxiv.org/pdf/2002.05202
1. 연구 배경 (Background)
2017년 Transformer가 등장한 이후, 자연어 처리 분야에서는 Self-Attention과 Feed-Forward Network(FFN)를 중심으로 모델의 성능을 개선하기 위한 연구가 활발하게 진행되었습니다.
기존 Transformer의 FFN은 두 개의 선형 변환(Linear Transformation) 사이에 ReLU 또는 GELU와 같은 활성화 함수를 적용하는 구조를 사용했습니다.
하지만 이러한 구조는 입력 특징에 대해 고정된 형태의 비선형 변환을 수행하며, 입력에 따라 정보의 흐름을 조절하는 명시적인 게이팅(Gating) 구조는 포함하지 않습니다.
한편, 기존 연구에서 제안된 Gated Linear Unit(GLU)은 두 개의 선형 변환 결과를 요소별로 곱하여 입력 정보의 흐름을 조절하는 구조로, 언어 모델링에서 활용되어 왔습니다.
본 논문은 이러한 GLU 구조를 Transformer의 FFN에 적용하고, 기존 ReLU 및 GELU 기반 구조보다 높은 성능을 달성할 수 있는지 검증한 연구입니다.
2. 연구 목적 (Objective)
본 연구의 목표는 Transformer의 Feed-Forward Network에 GLU 및 다양한 변형 구조를 적용하여 기존 활성화 함수보다 높은 언어 모델링 성능을 달성하는 것이었습니다.
특히 다음과 같은 가능성을 검증하고자 하였습니다.
- 기존 ReLU 및 GELU 기반 FFN을 GLU 기반 구조로 대체
- GLU에 다양한 활성화 함수를 결합하여 성능 비교
- 모델의 파라미터 수와 연산량을 동일한 수준으로 유지
- 사전학습(Pre-training) 및 다운스트림(Downstream) 자연어 이해 작업에서 성능 향상 검증
이를 통해 Transformer의 전체 구조를 크게 변경하지 않고도 FFN 내부의 활성화 및 게이팅 구조를 개선하는 것만으로 모델 성능을 향상시킬 수 있는지 확인하고자 하였습니다.
3. 연구 방법 (Method)
본 논문은 기존 Transformer의 FFN을 GLU 기반 구조로 변경하고, 다양한 활성화 함수를 적용하여 성능을 비교하였습니다.
기존 Transformer의 FFN은 다음과 같이 표현됩니다.
반면 GLU는 두 개의 선형 변환 결과를 요소별로 곱하는 구조를 사용합니다.
여기서
편향항은 생략하였습니다.
이러한 구조는 입력 정보에 따라 한쪽 경로에서 계산된 값이 다른 경로의 출력을 조절하도록 만듭니다.
논문에서 비교한 주요 GLU 변형은 다음과 같습니다.
- GLU: Sigmoid 함수를 활용한 기본 게이팅 구조
- Bilinear: 별도의 활성화 함수 없이 두 선형 변환 결과를 곱하는 구조
- ReGLU: ReLU 활성화 함수를 적용한 GLU 변형
- GEGLU: GELU 활성화 함수를 적용한 GLU 변형
- SwiGLU: Swish 활성화 함수를 적용한 GLU 변형
특히 GEGLU와 SwiGLU는 다음과 같이 표현됩니다.
이와 같은 구조를 Transformer FFN에 적용할 때는 게이팅 결과에 추가적인 선형 변환을 수행합니다.
또한 기존 FFN은 두 개의 가중치 행렬을 사용하지만, GLU 기반 FFN은 세 개의 가중치 행렬을 사용합니다.
따라서 논문에서는 공정한 비교를 위해 GLU 기반 FFN의 은닉 차원을 기존의 약 2/3 수준으로 줄여 파라미터 수와 연산량을 동일하게 유지하였습니다.
핵심 아이디어는 단순한 활성화 함수 변경이 아니라, 두 개의 선형 변환 경로를 결합하여 입력 정보의 흐름을 조절하는 게이팅 구조를 Transformer에 도입하는 것입니다.
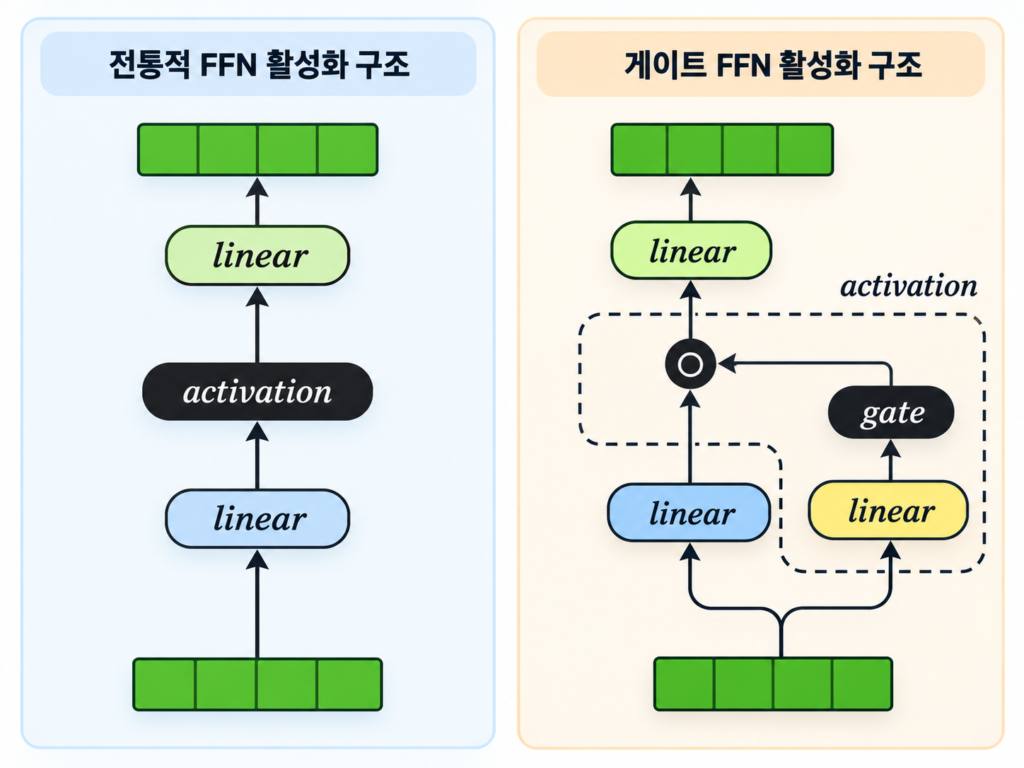
그림 1. 기존 FFN과 게이트 기반 FFN의 구조 비교
기존 FFN은 선형 변환과 활성화 함수를 순차적으로 적용하는 반면, 게이트 기반 FFN은 두 개의 경로를 통해 입력 정보를 선택적으로 조절합니다.
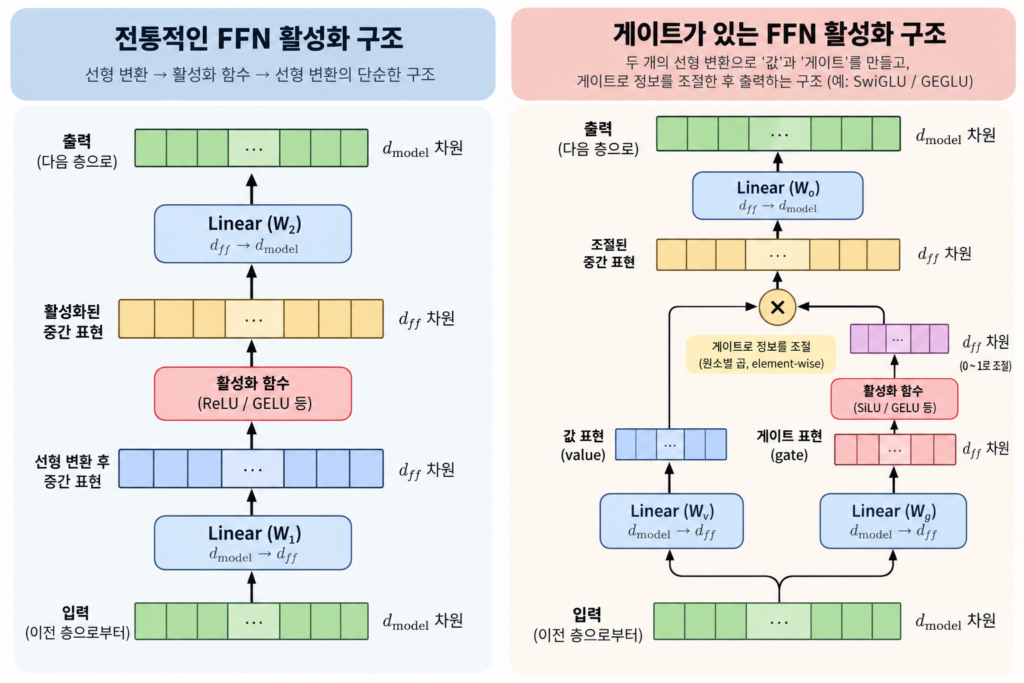
그림 2. 기존 FFN과 게이트 기반 FFN의 내부 연산 과정
기존 FFN은 하나의 중간 표현에 활성화 함수를 적용하지만, 게이트 기반 FFN은 값(Value) 경로와 게이트(Gate) 경로를 요소별로 곱하여 정보를 조절합니다.
4. 실험 (Experiment)
실험은 Google의 T5(Text-to-Text Transfer Transformer) 모델을 기반으로 수행되었습니다.
기본 모델 구조는 다음과 같습니다.
- Encoder 12개 Layer, Decoder 12개 Layer
- Hidden Dimension: 768
- Attention Head: 12개
- 기존 FFN Hidden Dimension: 3,072
- GLU 기반 FFN Hidden Dimension: 2,048
- 사전학습 데이터셋: C4(Colossal Clean Crawled Corpus)
- 사전학습: 524,288 Steps
연구에서는 기존 ReLU, GELU, Swish와 GLU 계열 구조를 비교하였으며, 각 모델의 파라미터 수와 연산량을 동일한 수준으로 맞추었습니다.
성능 평가는 크게 두 단계로 진행되었습니다.
1. 사전학습 성능 평가
C4 데이터셋에서 손실된 텍스트 구간을 복원하는 Span-Filling 작업을 수행하고, Log-Perplexity를 측정하여 언어 모델링 성능을 비교하였습니다.
2. 다운스트림 작업 평가
사전학습이 완료된 모델을 Fine-tuning하여 다음 자연어 이해 벤치마크에서 성능을 평가하였습니다.
- GLUE: 다양한 자연어 이해 작업 평가
- SuperGLUE: 보다 복잡한 자연어 이해 능력 평가
- SQuAD: 질문에 대한 정답 추출 능력 평가
또한 사전학습에서는 Dropout을 사용하지 않았으며, Fine-tuning 단계에서는 Dropout 0.1을 적용하였습니다.
5. 실험 결과 (Result)
실험 결과, GLU 기반 FFN은 기존 ReLU 및 GELU 기반 FFN보다 전반적으로 우수한 성능을 보였습니다.
특히 GEGLU와 SwiGLU는 사전학습 단계에서 가장 낮은 Log-Perplexity를 기록하였습니다.
사전학습 성능 비교
524,288 Steps 기준. Log-Perplexity는 낮을수록 우수합니다.
| FFN 구조 | Log-Perplexity |
|---|---|
| ReLU (Baseline) | 1.677 |
| GELU | 1.679 |
| Swish | 1.683 |
| GLU | 1.663 |
| Bilinear | 1.648 |
| ReGLU | 1.645 |
| SwiGLU | 1.636 |
| GEGLU | 1.633 |
다운스트림 자연어 이해 작업에서도 전반적으로 성능 향상이 확인되었습니다.
주요 결과는 다음과 같습니다.
- GLUE 평균 점수: ReLU 83.80 → ReGLU 84.67
- SuperGLUE 평균 점수: ReLU 72.76 → SwiGLU 74.56
- SQuAD F1 점수: ReLU 90.87 → ReGLU 91.18
이러한 결과는 GLU 계열 구조가 사전학습 성능뿐 아니라 다양한 자연어 이해 작업에서도 효과적일 수 있음을 보여줍니다.
다만 모든 작업에서 하나의 변형이 항상 최고 성능을 기록한 것은 아닙니다.
본 논문의 중요한 성과는 파라미터 수와 연산량을 동일한 수준으로 유지하면서도 FFN 구조의 변경만으로 Transformer의 성능을 향상시켰다는 점입니다.
6. 장점과 한계 (Pros & Cons)
장점
- Transformer의 전체 구조를 크게 변경하지 않고 성능 향상 가능
- GLU 기반 게이팅 구조를 통해 입력 특징 간 상호작용 강화
- GEGLU와 SwiGLU의 우수한 사전학습 성능 검증
- 동일한 수준의 파라미터 수와 연산량으로 기존 FFN보다 높은 성능 달성
- 기존 Transformer 모델에 비교적 간단하게 적용 가능
- 이후 다양한 대규모 언어 모델의 FFN 구조 설계에 영향을 준 연구
한계
- 실험이 주로 T5 기반 Encoder-Decoder 구조에 집중됨
- 다양한 모델 크기와 아키텍처에서의 일반화 성능 검증이 제한적
- GLU 계열 구조가 성능을 향상시키는 이론적 원인에 대한 분석 부족
- 추가적인 선형 변환 경로로 인해 구현 방식에 따라 메모리 사용과 연산 효율에 차이가 발생할 수 있음
- 모든 다운스트림 작업에서 일관되게 동일한 GLU 변형이 최고 성능을 기록하지는 않음
특히 저자 역시 논문의 결론에서 GLU 변형이 우수한 성능을 보이는 명확한 이론적 원인을 제시하지 못했다고 언급하였습니다.
따라서 본 연구는 게이팅 구조의 효과를 실험적으로 입증하였지만, 이러한 성능 향상이 발생하는 근본적인 원리를 완전히 설명한 연구는 아닙니다.
7. 개인적인 평가 (Comment)
GLU Variants Improve Transformer는 Transformer의 핵심 구성 요소 중 하나인 Feed-Forward Network의 구조를 개선하여 모델의 표현 능력과 자연어 처리 성능을 향상시킬 수 있음을 보여준 의미 있는 연구입니다.
Transformer 관련 연구는 일반적으로 Self-Attention 구조에 많은 관심을 집중하지만, 본 논문은 상대적으로 단순하게 여겨질 수 있는 FFN 역시 모델 성능에 중요한 영향을 미친다는 점을 보여주었습니다.
특히 GEGLU와 SwiGLU는 기존 활성화 함수를 사용하는 대신 두 개의 선형 변환 경로를 결합하여 정보를 선택적으로 조절할 수 있도록 설계되었으며, 복잡한 아키텍처 변경 없이도 성능을 개선할 수 있다는 점에서 실용적인 가치가 높다고 생각합니다.
이후 SwiGLU는 LLaMA 계열을 비롯한 여러 현대 대규모 언어 모델에서 활용되었으며, GLU 기반 FFN은 Transformer 아키텍처의 중요한 설계 선택지 중 하나로 자리 잡았습니다.
이 논문의 가장 중요한 의미는 Transformer의 성능 향상이 반드시 Attention 구조의 변화에서만 비롯되는 것은 아니며, FFN 내부의 정보 처리 방식을 개선하는 것만으로도 모델의 표현 능력과 학습 성능을 높일 수 있다는 가능성을 제시했다는 점입니다.
Transformer와 LLM의 내부 구조를 공부하는 사람이라면 반드시 한 번 읽어볼 가치가 있는 논문이며, 특히 기존 FFN과 현대 LLM에서 활용되는 SwiGLU 기반 FFN의 차이를 이해하기 위한 출발점으로 적합한 연구라고 생각합니다.