논문명: RoFormer: Enhanced Transformer with Rotary Position Embedding
저자: Jianlin Su, Yu Lu, Shengfeng Pan, Ahmed Murtadha, Bo Wen, Yunfeng Liu
발표: arXiv 2021 / Neurocomputing 2024
link:https://arxiv.org/pdf/2104.09864
1. 연구 배경 (Background)
Transformer는 RNN과 달리 입력 토큰을 순차적으로 처리하지 않고 Self-Attention을 이용하여 모든 토큰을 동시에 처리합니다.
이러한 구조는 병렬 연산에 매우 유리하지만 한 가지 문제가 있습니다.
Self-Attention 자체만으로는 토큰의 순서(Position) 를 알 수 없다는 점입니다.
예를 들어,
나는 너를 좋아한다.
와
너는 나를 좋아한다.
는 같은 글짜로 구성되어 있지만 글짜의 위치가 달라지면서 의미 역시 달라집니다.
따라서 Transformer에서는 각 토큰이 문장에서 어느 위치에 존재하는지를 알려주기 위한 Positional Encoding이 필요합니다. 논문 역시 Self-Attention 기반 모델이 기본적으로 위치에 무관한 구조라는 점에서 출발합니다.
기존 Transformer는 대표적으로 다음과 같은 방법들을 사용했습니다.
- Absolute Position Encoding
- Sinusoidal Position Encoding
- Learnable Position Embedding
- Relative Position Encoding
초기 Transformer에서는 Sin과 Cos 함수를 이용한 Absolute Position Encoding을 토큰 임베딩에 직접 더했습니다.
즉,
Token Embedding + Position Embedding
형태로 위치 정보를 추가했습니다.
하지만 이러한 방식은 단어가 문장 내에서 몇 번째 위치에 있는가를 나타내는 데 초점이 맞춰져 있습니다.
실제 자연어에서는 절대적인 위치보다,
두 단어가 서로 얼마나 떨어져 있는가?
와 같은 Relative Position(상대적 위치) 정보가 더 중요할 수 있습니다.
RoFormer 논문은 이러한 문제를 해결하기 위해 새로운 위치 인코딩 방식인 RoPE(Rotary Position Embedding) 를 제안합니다.
2. 연구 목적 (Objective)
RoFormer의 핵심 목표는 Transformer의 Self-Attention에 상대적 위치 정보를 자연스럽고 효율적으로 포함시키는 것입니다.
기존 위치 임베딩처럼 Position Vector를 단순히 더하는 것이 아니라,
Query와 Key 벡터를 위치에 따라 회전(Rotation)시키는 방식
을 사용합니다.
이를 통해 하나의 구조 안에서
- Absolute Position 정보 표현
- Relative Position 관계 표현
- 긴 Sequence에 대한 일반화
- Self-Attention과의 자연스러운 결합
을 동시에 달성하고자 하였습니다.
논문의 핵심 아이디어를 한 문장으로 정리하면 다음과 같습니다.
토큰의 위치를 별도의 벡터로 더하지 말고, Query와 Key 벡터를 위치에 따라 회전시키자.
3. 연구 방법 (Method)
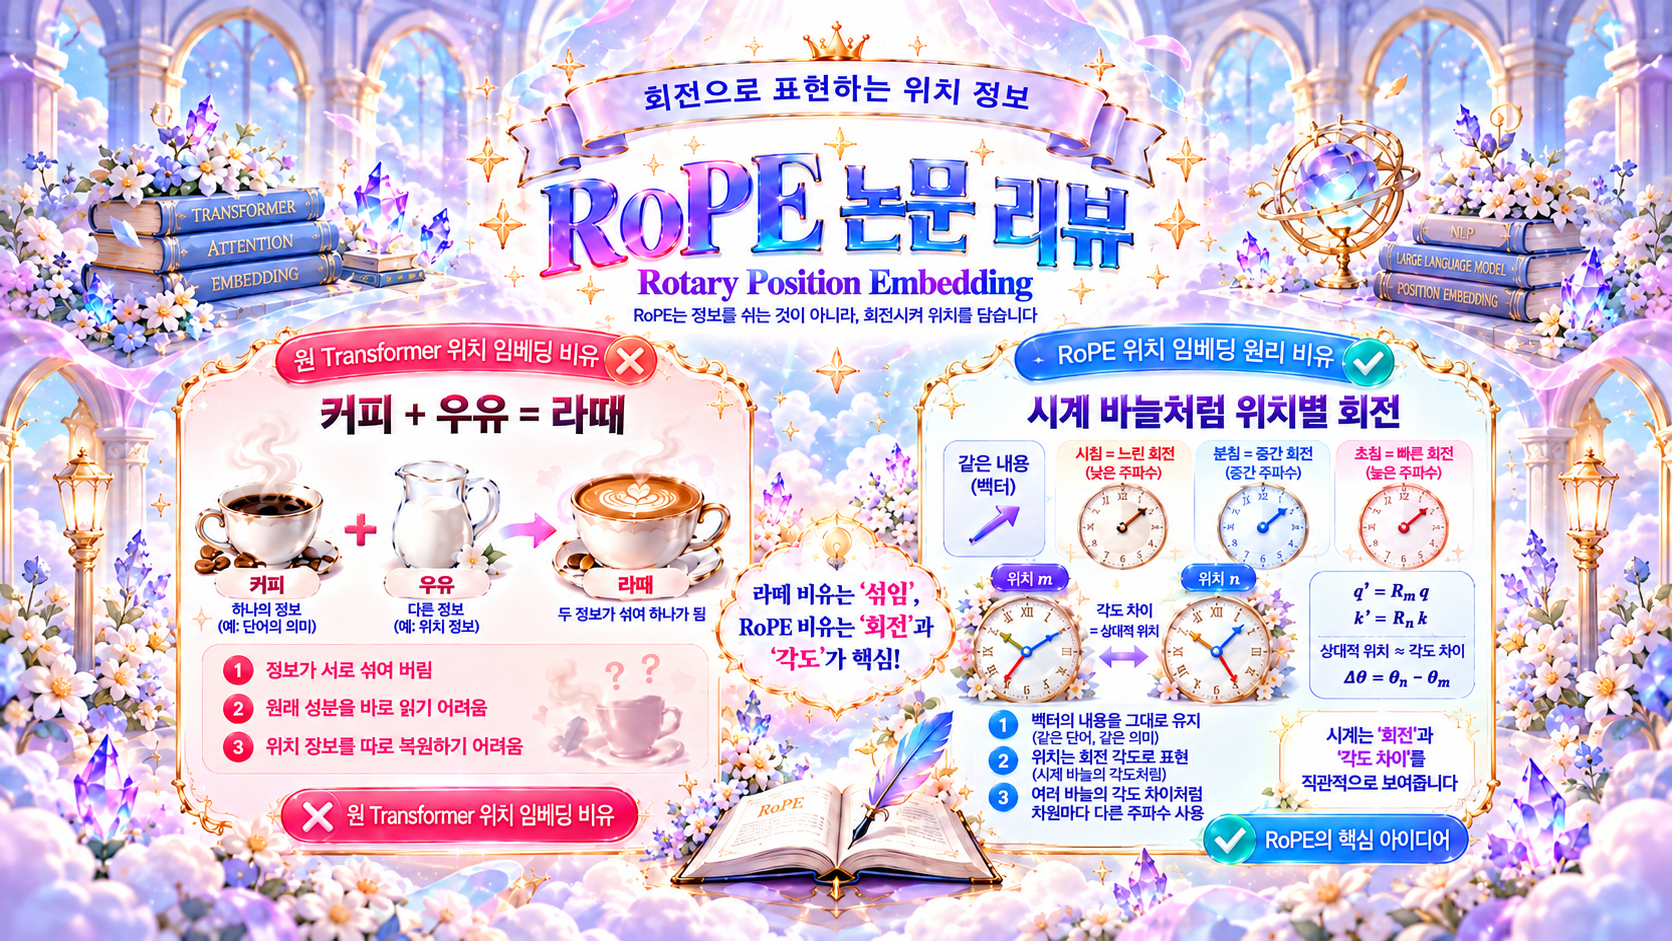
RoPE의 가장 중요한 아이디어는 Rotation Matrix(회전 행렬) 를 이용해 위치 정보를 Query와 Key에 삽입하는 것입니다.
기존 Positional Encoding
기존 Transformer에서는 일반적으로 다음과 같이 표현할 수 있습니다.
xᵢ + pᵢ
여기서
- xᵢ : Token Embedding
- pᵢ : Position Embedding
입니다.
즉, 토큰 정보에 위치 정보를 더하는 방식(Additive Position Encoding) 입니다.
반면 RoPE는 위치 정보를 더하지 않습니다.
대신 Query와 Key 벡터 자체를 위치에 따라 회전시킵니다. 논문은 기존의 additive 방식과 달리 RoPE가 multiplicative 방식이라는 점을 명확히 강조합니다.
Rotary Position Embedding
RoPE에서는 먼저 Query와 Key를 계산합니다.
qₘ = Wq · xₘ
kₙ = Wk · xₙ
그리고 각각의 위치에 따라 회전 행렬을 적용합니다.
qₘ’ = Rₘ · qₘ
kₙ’ = Rₙ · kₙ
여기서
- m, n : Token의 위치
- Rₘ, Rₙ : 해당 위치에 따른 Rotation Matrix
입니다.
2차원 벡터의 경우 회전 행렬은 다음과 같은 형태입니다.
R(mθ) =
[ cos(mθ) -sin(mθ) ]
[ sin(mθ) cos(mθ) ]
즉, 위치가 달라질수록 벡터가 서로 다른 각도로 회전합니다.
실제 Transformer에서는 Hidden Dimension 전체를 2개씩 묶어 각각 다른 주파수 θ를 이용해 회전시킵니다. 논문에서는 d차원 공간을 d/2개의 2차원 부분 공간으로 나누어 이 아이디어를 일반화합니다.
왜 회전을 사용하는가?
RoPE에서 가장 중요한 부분은 Query와 Key의 Inner Product입니다.
두 토큰의 Attention Score를 계산하면
qₘ’ᵀ kₙ’
이 되고,
회전 행렬의 성질에 의해 결과적으로 위치 m과 n 각각보다는
n – m
즉, 두 토큰 사이의 상대적인 거리가 Attention 계산에 자연스럽게 들어가게 됩니다.
이를 단순하게 표현하면,
Absolute Position → Rotation
Relative Position → Rotation Angle의 차이
가 됩니다.
예를 들어,
- Token A : Position 3
- Token B : Position 7
이라면 Attention에서는 두 위치 자체보다
7 – 3 = 4
라는 상대적 관계가 자연스럽게 반영됩니다. 논문에서 제시한 RoPE의 기본 설계 목표 역시 Q와 K의 내적이 두 토큰의 상대 위치에 의존하도록 만드는 것입니다.
RoPE의 핵심 특징
RoPE는 다음과 같은 특징을 가지고 있습니다.
- Position Embedding을 Token Embedding에 직접 더하지 않음
- Query와 Key에만 Rotation 적용
- Absolute Position을 회전 각도로 표현
- Attention 계산 과정에서는 Relative Position이 자연스럽게 나타남
- 추가적인 학습 가능한 Position Parameter가 필수적이지 않음
- Vector Norm을 유지하면서 위치 정보 적용 가능
- 긴 Sequence에 대한 확장성이 비교적 좋음
- Linear Attention과 결합 가능
또한 논문에서는 토큰 간 상대적 거리가 증가할수록 내적의 영향이 감소하는 Long-term Decay 특성을 분석합니다. 이는 멀리 떨어진 토큰보다 가까운 토큰 사이의 관계가 일반적으로 더 강하다는 자연어의 특성과 어느 정도 부합합니다.
4. 실험 (Experiment)
논문에서는 RoPE의 효과를 검증하기 위해 여러 NLP Task에서 실험을 진행했습니다.
주요 실험은 다음과 같습니다.
- Machine Translation
- Pre-training Language Modeling
- GLUE Benchmark
- Linear Attention 기반 Performer
- Chinese Long Text Classification
모든 실험은 총 8개의 V100 GPU 환경에서 수행되었습니다.
Machine Translation
WMT 2014 English-German 데이터셋을 사용했습니다.
약 450만 개의 영어-독일어 문장 Pair를 이용하여 기존 Transformer와 RoFormer를 비교했습니다.
평가 지표는 BLEU Score입니다.
Language Model Pre-training
BERT를 Baseline으로 사용하고 기존 Position Encoding 대신 RoPE를 적용했습니다.
Pre-training 데이터로는
- BookCorpus
- Wikipedia
를 사용했습니다.
최대 Sequence Length는 512, Batch Size는 64이며 100,000 Step 동안 학습했습니다.
GLUE Benchmark
RoFormer의 일반적인 NLP 성능을 평가하기 위해 다음 GLUE Task를 사용했습니다.
- MRPC
- SST-2
- QNLI
- STS-B
- QQP
- MNLI
Accuracy, F1 Score, Spearman Correlation 등의 지표를 이용하여 BERT와 비교했습니다.
Long Text Experiment
RoPE가 긴 Sequence에서도 효과적으로 동작하는지 확인하기 위해 중국어 Long Text 데이터셋인 CAIL2019-SCM을 사용했습니다.
이 데이터셋은 중국 최고인민법원의 판례 설명으로 구성되어 있으며, 많은 문서가 512자 이상이기 때문에 Long Context 모델의 성능을 평가하기 적합합니다.
5. 실험 결과 (Result)
실험 결과 RoPE는 여러 Task에서 기존 Position Encoding 방식과 비교하여 경쟁력 있는 성능을 보여주었습니다.
Machine Translation
WMT14 English-German에서
- Transformer-base : BLEU 27.3
- RoFormer : BLEU 27.5
를 기록했습니다.
큰 차이는 아니지만 동일한 Transformer 구조에서 위치 인코딩 방식을 변경하는 것만으로 성능 향상이 나타났습니다.
Pre-training
BERT와 동일한 조건에서 Pre-training한 결과,
RoFormer가 더 빠르게 Loss가 감소하는 경향
을 보여주었습니다.
즉, RoPE가 단순한 위치 정보 표현뿐만 아니라 학습 수렴에도 긍정적인 영향을 줄 가능성을 보여주었습니다.
GLUE
GLUE Benchmark에서는 모든 Dataset에서 RoFormer가 BERT를 능가한 것은 아닙니다.
논문 결과를 보면 MRPC, STS-B, QQP에서는 RoFormer가 더 높은 결과를 보였지만 SST-2, QNLI, MNLI에서는 BERT가 더 높은 결과를 기록했습니다.
따라서 RoPE를 적용한다고 해서 모든 NLP Task의 성능이 자동으로 향상되는 것은 아니라는 점도 확인할 수 있습니다.
Long Text
Long Text 실험에서는 RoPE의 장점이 보다 뚜렷하게 나타났습니다.
CAIL2019-SCM Test Accuracy는 다음과 같습니다.
- BERT-512 : 67.77%
- WoBERT-512 : 68.10%
- RoFormer-512 : 68.29%
- RoFormer-1024 : 69.79%
특히 Sequence Length를 512 → 1024로 증가시키면서 성능이 향상되었습니다.
RoFormer-1024는 WoBERT-512보다 절대 정확도 기준 약 1.69%p, 같은 논문에서 비교한 RoFormer-512보다 약 1.5%p 높은 Test Accuracy를 기록했습니다.
이 결과는 RoPE가 긴 Sequence를 처리하는 데 유리할 가능성을 보여줍니다.
6. 장점과 한계 (Pros & Cons)
장점
- Relative Position을 자연스럽게 Attention에 반영
- Position Embedding을 단순히 더하는 방식보다 수학적으로 깔끔한 구조
- Query와 Key만 회전시키기 때문에 기존 Self-Attention 구조에 적용하기 쉬움
- 별도의 학습 가능한 Position Embedding이 반드시 필요하지 않음
- 벡터의 Norm을 유지하면서 위치 정보 표현 가능
- 긴 Sequence에 대한 확장성이 좋음
- Linear Attention에도 적용 가능
- 구현이 비교적 간단함
특히 RoPE의 가장 큰 장점은
Absolute Position을 이용해 Query와 Key를 회전시키면서, Attention Score에서는 자연스럽게 Relative Position이 나타난다는 점
이라고 볼 수 있습니다.
한계
- RoPE 자체가 Transformer의 O(N²) Self-Attention 복잡도 문제를 해결하는 것은 아님
- 매우 긴 Context에서는 원래 학습 길이를 크게 넘어갈 경우 성능이 떨어질 수 있음
- 회전 주파수 θ 설정에 따라 Long Context 성능이 영향을 받을 수 있음
- 주기적인 Sin/Cos 구조를 사용하기 때문에 매우 먼 위치에서는 Position 표현 문제가 발생할 수 있음
- 모든 NLP Task에서 기존 Position Embedding보다 항상 높은 성능을 보장하지 않음
- 원 논문 역시 RoPE가 왜 일부 Baseline보다 더 빠르게 수렴하는지에 대한 완전한 설명을 제공하지 못했다고 명시함
- Long Text에서 성능이 향상되는 이유 역시 이론적으로 완전히 설명되지는 않음
따라서 RoPE 이후에는 긴 Context 문제를 개선하기 위해 RoPE Scaling과 Frequency 조절을 다루는 다양한 후속 연구들이 등장했습니다.
7. 개인적인 평가 (Comment)
RoPE는 Transformer 구조 자체를 크게 변경하지 않으면서 Position Information을 Attention 안에 매우 자연스럽게 포함시킨 방법이라는 점에서 의미가 큰 연구라고 생각합니다.
기존 Transformer의 Positional Encoding이
“Token Embedding에 위치 정보를 추가한다”
라는 접근이었다면,
RoPE는 이를
“Token의 Query와 Key를 위치에 따라 회전시킨다”
라는 관점으로 바꿨습니다.
특히,
각 토큰은 자신의 절대 위치만큼 회전하지만, 두 벡터의 Attention을 계산하면 두 토큰 사이의 상대적 위치 차이가 나타난다
는 아이디어가 RoPE의 핵심이라고 생각합니다.
수식만 처음 보면 상당히 복잡해 보이지만 개념적으로는 의외로 단순합니다.
위치가 다르면 벡터를 다른 각도로 회전시키고, 두 벡터의 각도 차이를 이용해 상대적 위치를 표현한다.
라고 이해하면 RoPE의 기본 개념을 쉽게 잡을 수 있습니다.
또한 이 논문의 의미는 RoFormer라는 하나의 모델에만 있지 않습니다.
RoPE는 이후 Transformer 기반 모델에서 널리 활용되는 위치 표현 방식이 되었고, 특히 긴 Context를 다루는 LLM을 이해하기 위해 매우 중요한 개념 중 하나가 되었습니다.
개인적으로 RoPE는 Transformer의 Self-Attention 구조와 수학적으로 매우 잘 맞는 Position Encoding 방법이며, 현대 LLM의 구조를 공부하려는 사람이라면 반드시 이해해야 하는 핵심 기술 중 하나라고 생각합니다.
Transformer의 기본적인 Positional Encoding을 공부한 다음 RoPE를 공부하면,
Absolute Position → Relative Position → Rotary Position
으로 이어지는 Position Encoding 발전 과정을 훨씬 쉽게 이해할 수 있습니다.
한 줄 정리
RoPE(Rotary Position Embedding)는 Query와 Key 벡터를 위치에 따라 회전시켜, Attention 계산 과정에서 두 Token 사이의 상대적인 위치 관계가 자연스럽게 반영되도록 만든 Positional Encoding 방법입니다.