논문명: Training Language Models to Follow Instructions with Human Feedback
저자: Long Ouyang et al.
발표: NeurIPS 2022
InstructGPT는 OpenAI가 2022년에 발표한 논문 「Training Language Models to Follow Instructions with Human Feedback」에서 소개된 언어 모델입니다.
GPT-3가 Few-shot Learning과 In-Context Learning을 통해 하나의 거대한 언어 모델이 여러 작업을 수행할 수 있다는 가능성을 보여주었다면, InstructGPT는 여기에서 한 단계 더 나아가 중요한 질문을 던집니다.
“언어 모델이 단순히 그럴듯한 문장을 생성하는 것을 넘어, 사용자가 원하는 의도를 제대로 이해하고 따르게 만들 수 있을까?”
이 논문은 오늘날 대규모 언어 모델에서 매우 중요하게 사용되는 Instruction Tuning과 RLHF(Reinforcement Learning from Human Feedback)의 대표적인 연구 중 하나입니다.
1. 연구 배경 (Background)
GPT-3는 1,750억 개의 파라미터를 가진 대규모 언어 모델로, 별도의 Fine-tuning 없이도 Prompt 안에 Instruction이나 몇 개의 Example을 제공하면 다양한 작업을 수행할 수 있음을 보여주었습니다.
예를 들어,
Translate the following sentence into Korean.
I love artificial intelligence.
라고 입력하면 GPT-3는 학습되지 않은 새로운 입력이라도 번역 작업을 수행할 수 있습니다.
하지만 여기에는 중요한 문제가 있었습니다.
GPT-3의 기본적인 학습 목표는 어디까지나
“앞의 Token을 보고 다음 Token을 예측하는 것”
입니다.
즉,
Pre-training Objective
이전 문맥 → 가장 가능성이 높은 다음 Token 예측
입니다.
그러나 실제 사용자가 원하는 것은 조금 다릅니다.
사용자는 모델이 단순히 다음 문장을 잘 이어 쓰기를 원하는 것이 아니라,
- 질문에 정확하게 답하기
- 사용자의 명령을 따르기
- 요구한 형식을 지키기
- 사실이 아닌 내용을 만들지 않기
- 위험하거나 유해한 답변을 피하기
등을 기대합니다.
즉,
언어 모델의 학습 목표
다음 Token을 잘 예측하기
와
사용자가 원하는 목표
사용자의 의도를 이해하고 유용한 답변을 제공하기
사이에 차이가 존재합니다.
InstructGPT 논문에서는 이러한 문제를 Alignment 문제로 바라봅니다.
실제로 연구진은 대규모 언어 모델이 커진다고 해서 자동으로 사용자 지시를 더 잘 따르는 것은 아니며, 사실이 아닌 내용을 생성하거나 유해한 표현을 만들거나 아예 질문의 의도를 제대로 따르지 않는 문제가 존재한다고 설명합니다.
그래서 연구진은 다음과 같은 질문을 제기합니다.
“사람이 원하는 답변을 직접 보여주고, 사람들이 어떤 답변을 더 좋아하는지 평가하게 한 뒤, 그 피드백을 이용해 언어 모델을 학습시킬 수 있을까?”
이 질문에서 InstructGPT 연구가 시작됩니다.
GPT-3과 InstructGPT 답변 비교 참조 사이트:https://openai.com/ko-KR/index/instruction-following
2. 연구 목적 (Objective)
InstructGPT의 핵심 목표는 단순히 GPT-3보다 더 큰 모델을 만드는 것이 아닙니다.
오히려 기존 GPT-3를 기반으로,
사람의 피드백을 이용하여 모델이 사용자의 지시와 의도에 더 잘 맞는 답변을 생성하도록 만드는 것
이 연구의 핵심 목적입니다.
연구진은 특히 좋은 언어 모델이 다음 세 가지 특성을 가져야 한다고 설명합니다.
Helpful
사용자가 원하는 작업을 제대로 수행해야 합니다.
예를 들어,
다음 문장을 세 문장으로 요약해줘.
라고 요청했다면 실제로 요약을 수행하고, 가능하면 세 문장이라는 조건도 지켜야 합니다.
Honest
잘 모르는 내용을 사실처럼 만들어내거나 사용자를 속여서는 안 됩니다.
즉, 오늘날 흔히 말하는 Hallucination을 줄이는 것이 중요합니다.
Harmless
편향적이거나 지나치게 유해한 내용을 생성하지 않도록 해야 합니다.
즉,
Helpful + Honest + Harmless
한 모델을 만드는 것이 Alignment의 중요한 목표입니다.
이를 위해 InstructGPT에서는 RLHF, 즉
Reinforcement Learning from Human Feedback
이라는 방법을 사용합니다.
쉽게 말하면,
“사람이 더 좋아하는 답변을 많이 만들도록 모델을 학습시키는 방법”
이라고 이해할 수 있습니다.
3. 연구 방법 (Method)
이미지 참조 사이트: https://openai.com/ko-KR/index/instruction-following
InstructGPT는 완전히 새로운 Transformer 구조를 만든 모델이 아닙니다.
기본 모델은 기존의 GPT-3 Architecture를 그대로 사용했습니다.
연구에서는 다음 세 가지 크기의 GPT-3 모델을 사용했습니다.
- 1.3B
- 6B
- 175B
그리고 이 GPT-3 모델들을 사람의 피드백을 이용해 추가 학습했습니다.
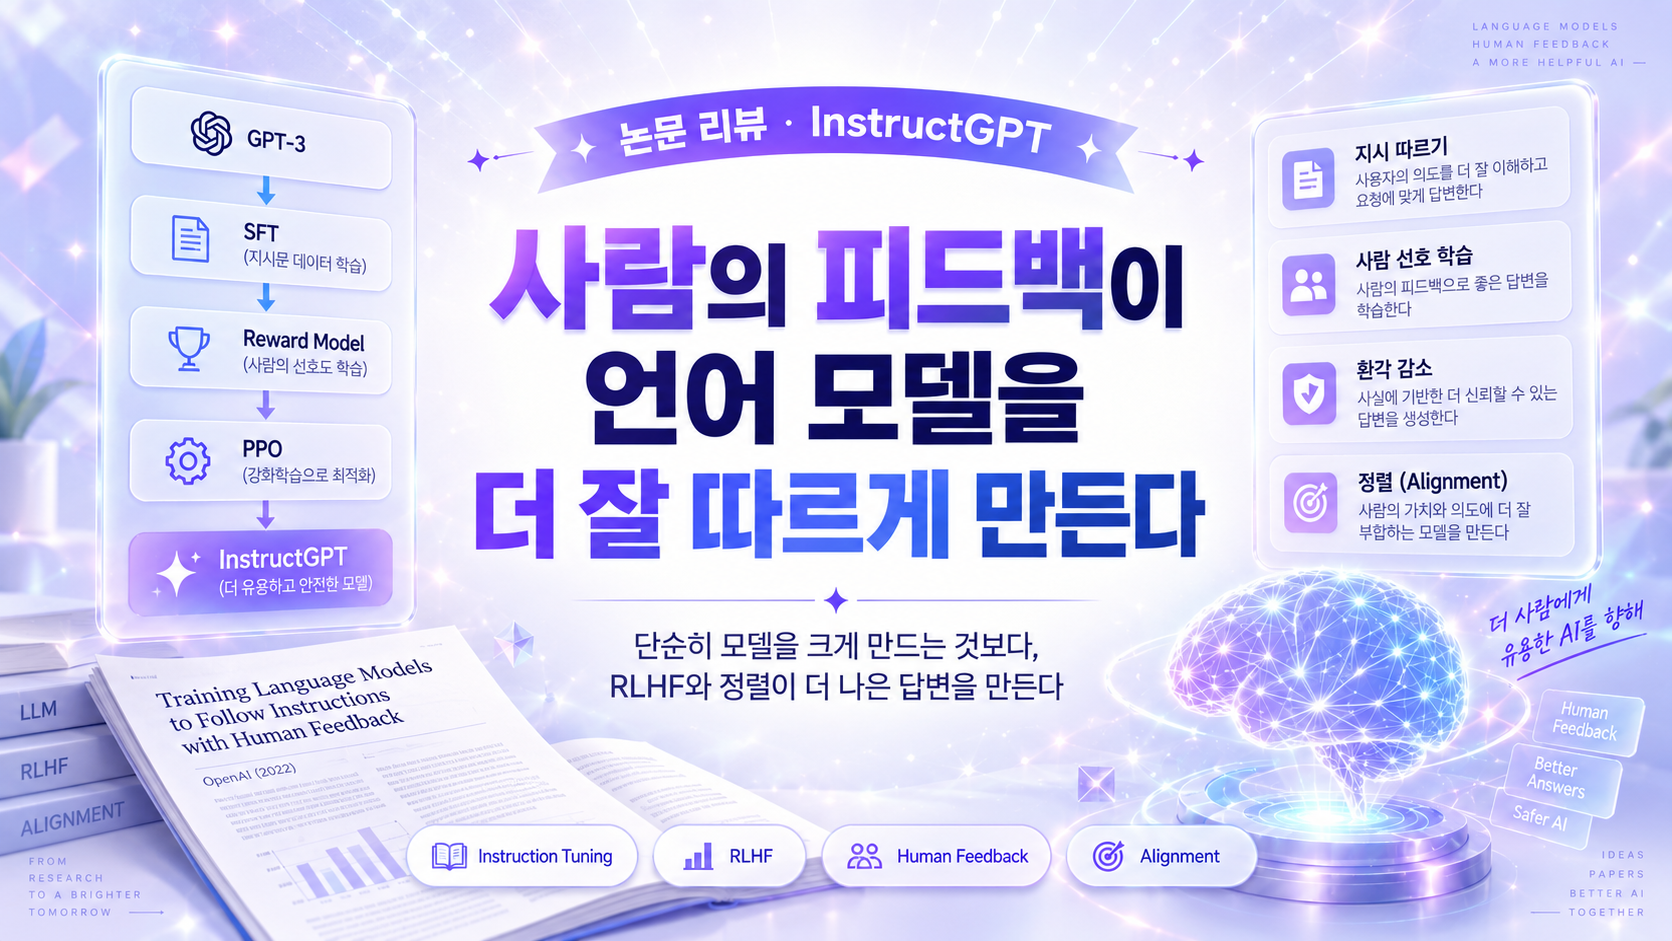
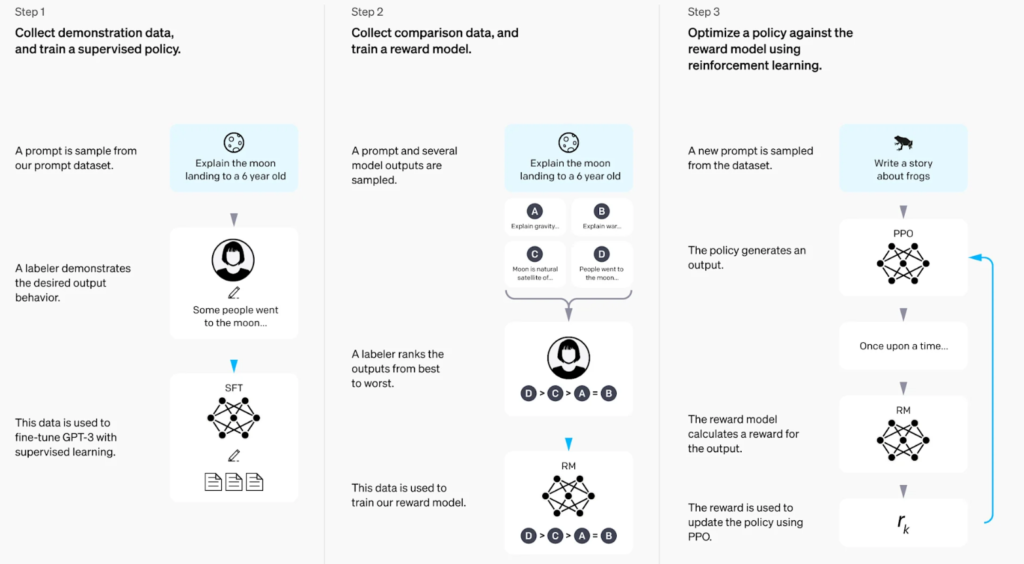
InstructGPT의 전체 학습 과정은 크게 세 단계로 나눌 수 있습니다.
GPT-3
↓
① Supervised Fine-Tuning (SFT)
↓
② Reward Model (RM)
↓
③ Reinforcement Learning with PPO
↓
InstructGPT
이 세 단계가 InstructGPT 논문의 가장 중요한 부분입니다.
Step 1. Supervised Fine-Tuning (SFT)
첫 번째 단계에서는 사람이 직접 좋은 답변의 예시를 작성합니다.
예를 들어 Prompt가
Explain gravity to a 6-year-old child.
라고 한다면 사람이 원하는 형태의 답변을 직접 작성합니다.
예를 들어,
Gravity is like an invisible force that pulls things toward the ground.
That’s why when you jump, you come back down.
과 같은 식입니다.
즉,
Prompt → 사람이 작성한 좋은 Answer
형태의 학습 데이터를 만드는 것입니다.
그리고 기존 GPT-3 모델을 이 데이터로 Fine-tuning합니다.
이를
Supervised Fine-Tuning, SFT
라고 합니다.
연구에서는 API에서 얻은 Prompt와 Labeler가 직접 작성한 Prompt를 이용했으며, SFT 학습에는 약 13,000개의 Training Prompt가 사용되었습니다.
쉽게 표현하면,
GPT-3
인터넷 문장을 많이 읽어서 언어를 잘 생성하는 모델
에서
SFT Model
사람이 원하는 답변이 어떤 모습인지 예제를 보고 배운 모델
로 만드는 과정입니다.
Step 2. Reward Model 학습
하지만 여기에서 문제가 하나 발생합니다.
사람이 가능한 모든 질문에 대해 직접 정답을 작성할 수는 없습니다.
예를 들어 하나의 Prompt에 대해 여러 모델이 다음처럼 답변했다고 해보겠습니다.
Prompt
인공지능을 초등학생도 이해할 수 있도록 설명해줘.
Answer A
인공지능은 인간처럼 생각하는 기계입니다.
Answer B
인공지능은 컴퓨터가 많은 예제를 보고 규칙을 배워서 사진을 구분하거나 질문에 답하도록 만드는 기술입니다.
Answer C
인공지능은 1956년에 만들어졌으며 현재 모든 산업을 완전히 대체하고 있습니다.
이때 사람에게
“A, B, C 중 어떤 답변이 가장 좋은가?”
라고 물어볼 수 있습니다.
사람이
B > A > C
와 같은 순위를 매깁니다.
InstructGPT 연구에서는 하나의 Prompt에 대해 여러 개의 모델 답변을 생성하고, Labeler들에게 어떤 답변이 더 좋은지 Ranking하도록 했습니다.
실제로 한 Prompt에 대해 약 4~9개의 응답을 보여주고 사람이 선호 순위를 평가했습니다.
이러한 데이터를 이용해 새로운 모델을 하나 학습합니다.
바로
Reward Model (RM)
입니다.
Reward Model의 역할은 다음과 같습니다.
Prompt + Answer
↓
Reward Model
↓
Score
예를 들어,
Answer A → 2.1
Answer B → 5.8
Answer C → -1.3
처럼 사람이 좋아할 가능성이 높은 답변에 더 높은 점수를 주도록 학습합니다.
즉 Reward Model은
“사람이라면 이 답변을 얼마나 선호할까?”
를 예측하는 모델이라고 이해하면 됩니다.
연구에서는 Reward Model 학습을 위해 약 33,000개의 Training Prompt를 사용했으며, 계산량과 학습 안정성 등의 이유로 6B 크기의 Reward Model을 사용했습니다.
Step 3. Reinforcement Learning with PPO
마지막 단계에서는 Reward Model을 이용해 실제 언어 모델을 다시 학습합니다.
여기에서 Reinforcement Learning, 즉 강화학습이 등장합니다.
기본 구조는 매우 간단합니다.
Prompt
↓
Language Model
↓
Answer 생성
↓
Reward Model 평가
↓
Reward Score
그리고 높은 Reward를 받은 답변을 더 많이 생성하도록 Language Model을 업데이트합니다.
이를 반복하면 모델은 점점
Reward Model이 높은 점수를 주는 답변
을 생성하는 방향으로 변화합니다.
그리고 Reward Model은 앞 단계에서
사람이 선호하는 답변
을 예측하도록 학습되어 있습니다.
따라서 최종적으로는
Human Preference
↓
Reward Model
↓
Reward
↓
Language Model Training
이라는 구조가 만들어집니다.
이것이 바로
Reinforcement Learning from Human Feedback, RLHF
의 핵심 개념입니다.
InstructGPT에서는 강화학습 알고리즘으로 PPO(Proximal Policy Optimization)를 사용했습니다.
따라서 전체 과정을 아주 간단하게 정리하면 다음과 같습니다.
① 사람이 좋은 답변을 직접 보여줌
↓
SFT
↓
② 사람이 여러 답변의 순위를 평가
↓
Reward Model
↓
③ Reward Model이 높은 점수를 주는 답변을 만들도록 강화학습
↓
PPO
↓
InstructGPT
4. 실험 (Experiment)
연구진은 InstructGPT가 실제로 GPT-3보다 사용자의 지시를 잘 따르는지 확인하기 위해 다양한 방식으로 평가했습니다.
특히 기존의 NLP Benchmark 점수만 보는 것이 아니라 사람이 실제 모델의 답변을 직접 비교하는 Human Evaluation을 중요한 평가 지표로 사용했습니다.
예를 들어 동일한 Prompt에 대해
GPT-3 Answer
와
InstructGPT Answer
를 사람에게 보여준 뒤
“어떤 답변이 더 좋은가?”
를 평가하게 했습니다.
연구에서는 다음 모델들을 비교했습니다.
- GPT-3
- Prompt를 개선한 GPT-3
- SFT Model
- PPO Model
- PPO-ptx Model
- InstructGPT
또한 여러 가지 공개 NLP Benchmark도 함께 사용했습니다.
대표적으로
- TruthfulQA
- RealToxicityPrompts
- SQuAD
- DROP
- HellaSwag
- WMT Translation
- Winogender
- CrowS-Pairs
등을 사용했습니다.
평가에서는 특히 다음 항목을 확인했습니다.
- Instruction Following
- Response Quality
- Truthfulness
- Hallucination
- Toxicity
- Bias
- 기존 NLP 능력 유지 여부
즉 단순히
“정답률이 높아졌는가?”
만 평가한 것이 아니라,
“사람들이 실제로 이 모델의 답변을 더 좋은 답변이라고 느끼는가?”
를 중요한 평가 기준으로 사용했다는 점이 특징입니다.
5. 실험 결과 (Result)
InstructGPT 논문의 가장 유명한 결과 중 하나는 모델 크기와 사용자 선호도가 반드시 비례하지 않는다는 사실입니다.
놀랍게도,
1.3B InstructGPT
의 답변이
175B GPT-3
의 답변보다 사람들에게 더 선호되었습니다.
즉,
1.3B InstructGPT > 175B GPT-3
라는 결과가 나타난 것입니다.
파라미터 수만 보면 175B GPT-3가 1.3B InstructGPT보다 100배 이상 큽니다.
하지만 인간의 피드백을 이용해 Alignment한 작은 모델의 답변이 훨씬 거대한 GPT-3보다 더 좋은 평가를 받은 것입니다.
이는 매우 중요한 결과입니다.
기존에는 흔히
Model Size ↑ → Performance ↑
라는 Scaling이 중요한 연구 방향이었다면 InstructGPT는
좋은 Training Method + Human Feedback → 사용자에게 더 좋은 Model
이라는 또 다른 방향을 보여주었습니다.
175B GPT-3 vs 175B InstructGPT
같은 크기의 모델끼리 비교하면 차이는 더욱 명확합니다.
175B InstructGPT의 답변은 일반 175B GPT-3보다 약
85 ± 3%
의 비교에서 더 선호되었습니다.
또한 Few-shot Prompt를 적용한 GPT-3와 비교해도 InstructGPT가 약
71 ± 4%
의 비교에서 더 선호되었습니다.
즉 좋은 Prompt만 사용하는 것보다도 인간 피드백으로 직접 모델을 학습시키는 것이 더 강력한 효과를 보여준 것입니다.
Hallucination 감소
InstructGPT는 사실이 아닌 정보를 만들어내는 현상도 줄였습니다.
특히 입력에 존재하는 정보만 사용해야 하는 Summarization이나 Closed-domain QA에서는 GPT-3의 Hallucination 비율이 약
41%
였던 반면 InstructGPT는 약
21%
로 감소했습니다.
즉 거의 절반 수준으로 감소한 것입니다.
Truthfulness 향상
TruthfulQA에서도 InstructGPT는 GPT-3보다 더 Truthful하고 Informative한 답변을 생성하는 경향을 보였습니다.
이는 단순히 사용자가
“사실대로 말해줘.”
라고 명령했을 때만 나타나는 것이 아니라, 기본적인 모델 행동 자체가 GPT-3보다 더 진실한 방향으로 변화했다는 점에서 의미가 있습니다.
Toxicity 감소
유해성 측면에서도 일정 수준의 개선이 나타났습니다.
특히 모델에게 안전하고 존중하는 방식으로 답변하도록 요청했을 때, InstructGPT는 GPT-3보다 Toxic Output을 약 25% 적게 생성했습니다.
다만 중요한 한계도 있었습니다.
안전하게 답하라는 Instruction이 없는 경우에는 이러한 장점이 사라지기도 했으며, 사회적 Bias를 측정하는 Winogender나 CrowS-Pairs에서는 GPT-3 대비 뚜렷한 개선을 확인하지 못했습니다.
즉,
RLHF = 모든 안전 문제 해결
은 아닙니다.
6. 장점과 한계 (Pros & Cons)
장점
- 인간의 피드백을 이용한 RLHF의 효과를 대규모 언어 모델에서 입증
- 사용자의 Instruction을 더 정확하게 따르는 모델 구현
- 단순한 Model Scaling보다 Alignment가 중요하다는 점을 보여줌
- 작은 1.3B InstructGPT가 175B GPT-3보다 높은 Human Preference 기록
- Hallucination 감소
- Truthfulness 향상
- 일부 Toxic Output 감소
- 실제 API 사용자 Prompt를 활용하여 현실적인 사용 환경에 가까운 데이터 구성
- SFT → Reward Model → PPO라는 현대적인 LLM Post-training Pipeline을 체계적으로 제시
- 이후 대화형 AI와 Instruction-following LLM 발전에 큰 영향을 줌
한계
하지만 InstructGPT에도 여러 가지 중요한 한계가 존재합니다.
Human Preference가 항상 정답은 아니다
Reward Model은 결국 사람이 제공한 평가 데이터를 기반으로 학습됩니다.
따라서
Human Labeler의 Preference
자체에 편향이 존재한다면 Reward Model에도 이러한 편향이 반영될 수 있습니다.
실제 연구에서도 InstructGPT가 어떤 보편적인 의미의 모든 인간 가치에 Alignment된 것이 아니라, 연구에 참여한 특정 Labeler와 연구진의 선호에 맞춰져 있다는 점을 명확하게 지적합니다.
Reward Model이 완벽하지 않다
Reward Model은 사람의 선호도를 완벽하게 이해하는 모델이 아닙니다.
단지
“사람이 어떤 답변을 더 좋아할 가능성이 높은지”
를 예측합니다.
따라서 Language Model이 Reward Model의 약점을 찾아 실제로는 좋지 않은 답변인데 높은 Reward를 얻는 방향으로 학습될 가능성도 존재합니다.
이러한 문제를 줄이기 위해 InstructGPT에서는 원래 SFT 모델과 너무 멀어지지 않도록 KL Penalty를 적용했습니다.
Alignment Tax
RLHF를 적용하면 사용자 선호도는 높아지지만 기존 언어 모델이 가지고 있던 일부 NLP Benchmark 성능이 떨어질 수도 있습니다.
논문에서는 이를
Alignment Tax
라고 표현합니다.
실제로 초기 PPO 모델에서는 SQuAD, DROP, HellaSwag, WMT 등의 일부 데이터셋에서 GPT-3보다 성능이 떨어지는 현상이 관찰되었습니다.
이를 줄이기 위해 연구진은 PPO 학습 중 기존 Pre-training 데이터를 함께 학습하는
PPO-ptx
방법을 사용했습니다.
여전히 Hallucination이 존재한다
InstructGPT가 GPT-3보다 Hallucination을 줄였다고 해서 Hallucination 문제가 해결된 것은 아닙니다.
모델은 여전히
- 존재하지 않는 사실을 생성하거나
- 잘못된 전제를 그대로 받아들이거나
- 간단한 문제에서도 실수하거나
- 필요 이상으로 길고 모호한 답변을 생성할 수 있습니다.
논문에서도 InstructGPT가 여전히 간단한 실수를 할 수 있다는 점을 명확하게 언급합니다.
7. 개인적인 평가 (Comment)
InstructGPT는 새로운 Transformer Architecture를 제안한 논문이라기보다는,
“이미 강력한 Pre-trained Language Model을 어떻게 사람이 실제로 사용하기 좋은 AI로 만들 것인가?”
라는 질문에 대한 중요한 답을 제시한 연구라고 생각합니다.
GPT-3까지의 발전을 보면 가장 중요한 관심사는 주로
Model Size
Training Data
Few-shot Learning
In-Context Learning
이었습니다.
하지만 InstructGPT부터 중요한 질문이 하나 추가됩니다.
“모델이 할 수 있는 것과 모델이 어떻게 행동해야 하는 것은 다른 문제이지 않을까?”
GPT-3는 이미 매우 많은 것을 할 수 있었습니다.
하지만
“이 문장을 요약해줘.”
라는 말을 했을 때 항상 정확히 요약하지 않을 수도 있고,
“두 문장으로 답해줘.”
라고 했는데 조건을 무시할 수도 있으며,
모르는 내용을 자신 있게 만들어낼 수도 있습니다.
InstructGPT는 이러한 문제를 해결하기 위해 사람의 피드백 자체를 Training Signal로 사용했습니다.
기존 언어 모델의 핵심 학습 방식이
Internet Text → Next Token Prediction
이었다면,
InstructGPT에서는 여기에
Human Demonstration → SFT
와
Human Preference → Reward Model → Reinforcement Learning
이라는 새로운 학습 과정이 추가됩니다.
즉,
Pre-training
은 모델에게
“언어를 어떻게 사용하는가?”
를 가르치고,
SFT
는
“사용자의 지시에 어떤 식으로 답해야 하는가?”
를 가르치며,
RLHF
는
“여러 가능한 답변 중 사람이 더 선호하는 답변은 무엇인가?”
를 가르친다고 이해하면 비교적 쉽게 정리할 수 있습니다.
특히 개인적으로 가장 인상적인 결과는
1.3B InstructGPT의 답변이 175B GPT-3보다 더 선호되었다는 점
입니다.
이는 단순히 파라미터 수를 늘리는 것만으로 좋은 AI Assistant가 만들어지는 것은 아니라는 사실을 잘 보여줍니다.
즉,
“얼마나 큰 모델인가?”
뿐만 아니라
“어떤 목표로 모델을 학습시켰는가?”
가 매우 중요하다는 것입니다.
이 관점에서 InstructGPT는 GPT 연구의 흐름을
Scaling 중심
에서
Scaling + Alignment + Post-training
으로 확장시킨 중요한 연구라고 볼 수 있습니다.
오늘날 다양한 LLM에서 Instruction Tuning, Preference Learning, RLHF와 같은 Post-training 기법이 중요한 이유를 이해하기 위해 반드시 알아둘 가치가 있는 논문이라고 생각합니다.
GPT-1 → GPT-2 → GPT-3 → InstructGPT 흐름
전체 GPT 발전 흐름을 공부한다면 다음과 같이 기억하면 이해하기 쉽습니다.
GPT-1
Pre-training + Fine-tuning
“먼저 대규모 텍스트로 언어를 배우고, Task별로 Fine-tuning하자.”
↓
GPT-2
Zero-shot Learning
“충분히 큰 언어 모델이라면 별도의 Fine-tuning 없이도 여러 작업을 수행할 수 있지 않을까?”
↓
GPT-3
Few-shot Learning + In-Context Learning
“모델을 훨씬 크게 만들면 Prompt 속 몇 개의 Example만 보고 새로운 Task를 수행할 수 있지 않을까?”
↓
InstructGPT
Instruction Following + RLHF + Alignment
“그렇다면 사람의 피드백을 이용해서 모델이 사용자의 의도에 맞게 행동하도록 만들 수 있지 않을까?”
이렇게 보면 GPT 연구의 발전 방향이 상당히 명확해집니다.
GPT-1 → 학습 방법
GPT-2 → 범용성
GPT-3 → In-Context Learning
InstructGPT → Alignment
으로 발전한 것입니다.
한 가지는 꼭 기억해두면 좋습니다.
InstructGPT 논문의 핵심을 한 문장으로 요약하면
“사람이 원하는 답변의 예시와 선호도를 학습 신호로 사용하면, 단순히 모델의 크기를 키우는 것보다 사용자의 지시를 더 잘 따르는 언어 모델을 만들 수 있다.”
조금 더 기술적으로 표현하면,
GPT-3 + Supervised Fine-Tuning + Reward Model + PPO 기반 RLHF → InstructGPT
라고 정리할 수 있습니다.
그래서 GPT-3 논문이 “Large Language Model이 무엇을 할 수 있는가?”를 보여준 논문이라면,
InstructGPT 논문은
“그 강력한 언어 모델을 어떻게 사람이 실제로 사용하기 좋은 AI Assistant로 만들 것인가?”
를 본격적으로 다룬 연구라고 볼 수 있습니다.
오늘날 LLM을 공부한다면 GPT-3 다음 단계에서 InstructGPT를 공부하는 것이 특히 중요한 이유도 바로 여기에 있습니다.